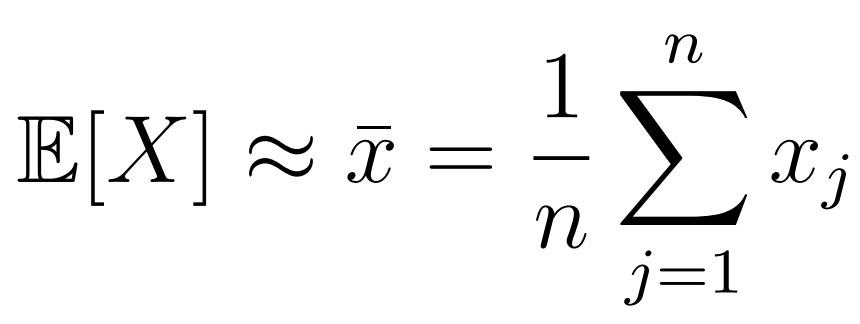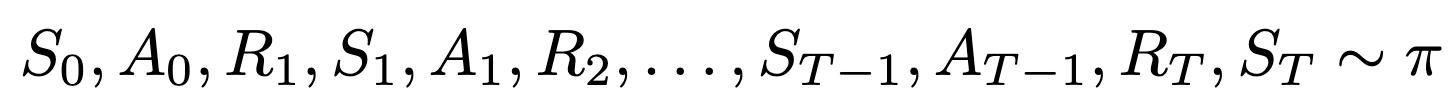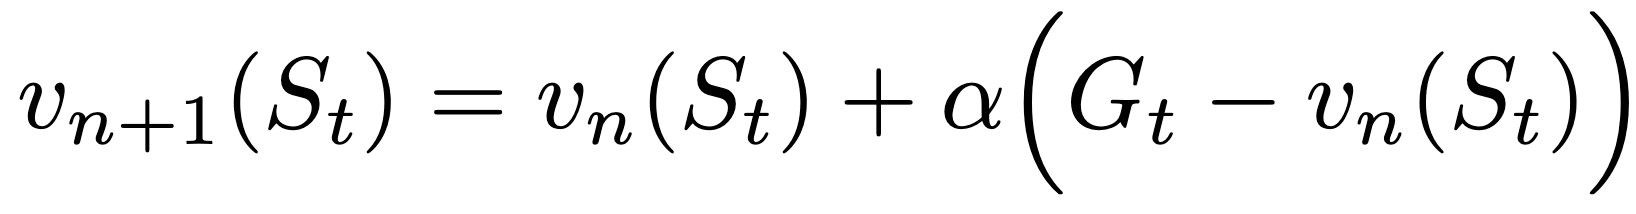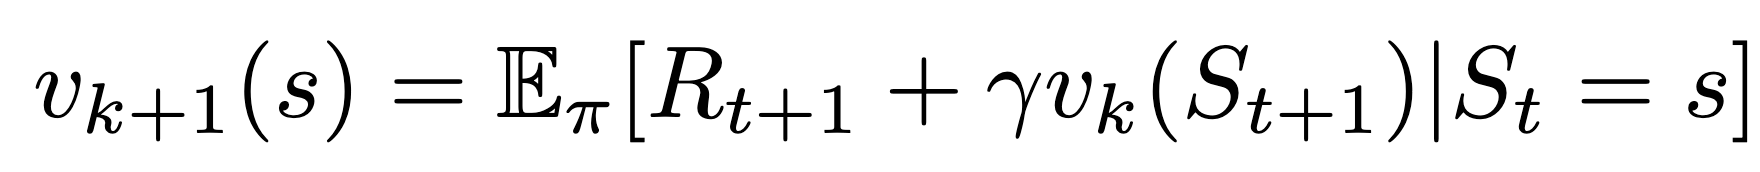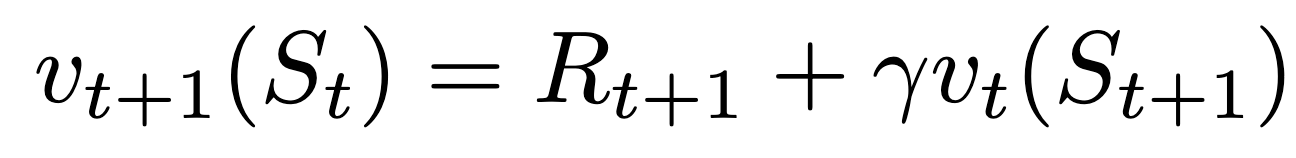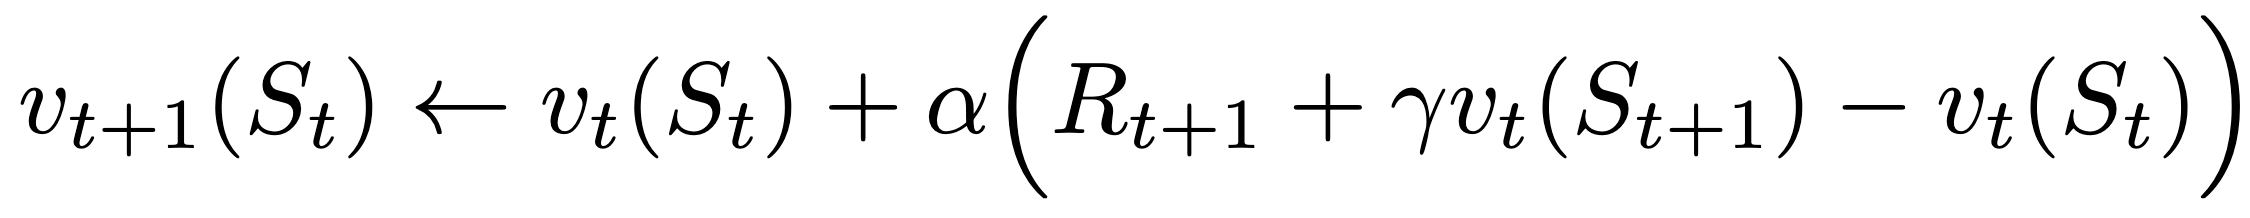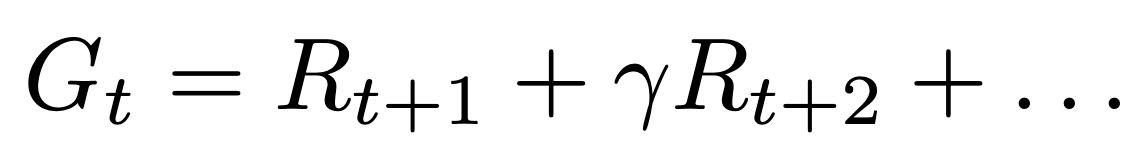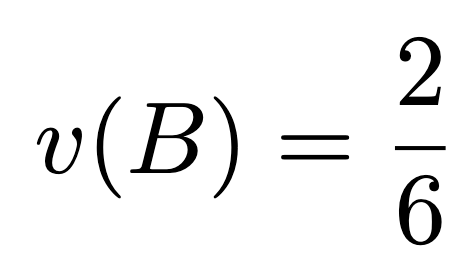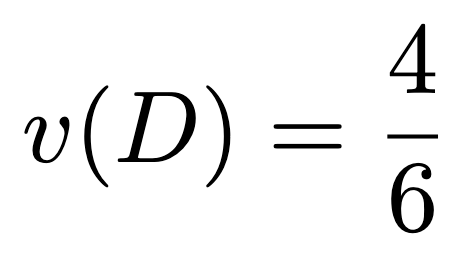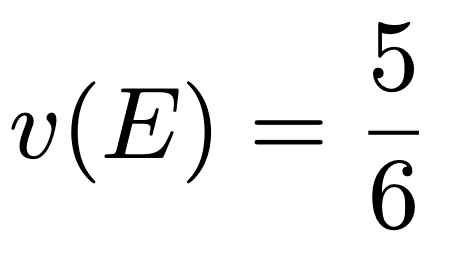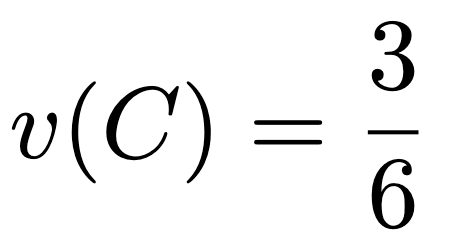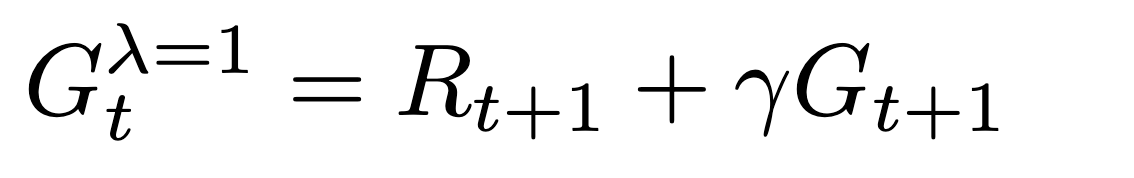

Reinforcement Learning · Lecture 4
Monte Carlo Methods and TD Learning
Rafael Fernandes Cunha
Today’s topics
1.Recap on Dynamic Programming
2.Monte Carlo algorithm
3.Temporal-Difference (TD) algorithms
1.TD(0)
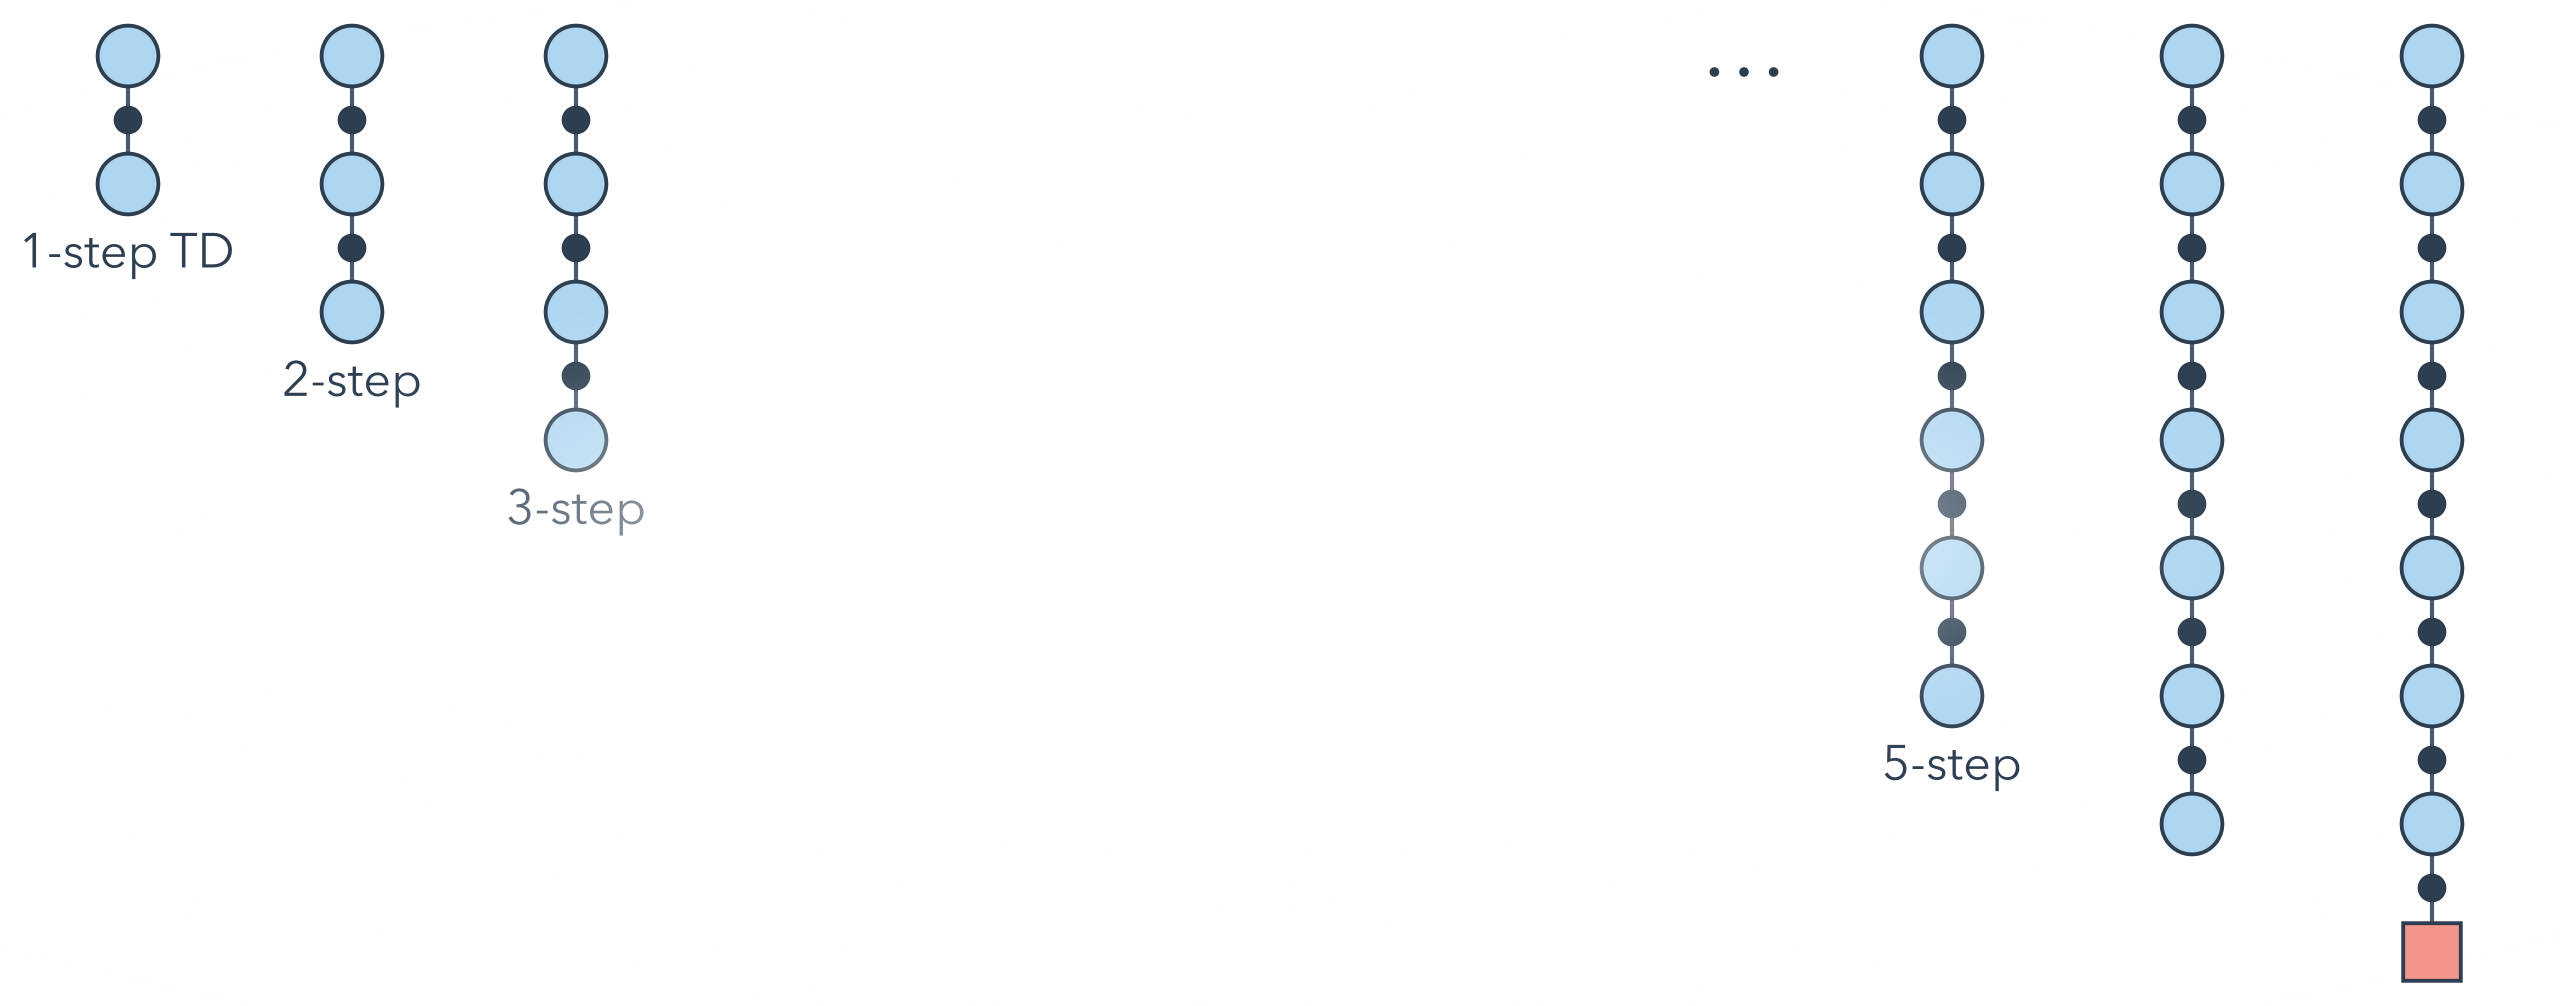
2.n-steps TD
3.TD()
2
1.Explain the Monte Carlo algorithm
2.Explain TD algorithms
3.Analyze the differences between Monte Carlo
and TD methods
Learning outcomes
Policy Improvement Theorem
Let and ’ be any pair of deterministic policies such that,
Then the policy must be as good as, or better than .
That is, it must obtain greater or equal expected return from all states
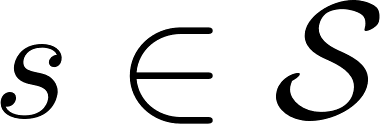
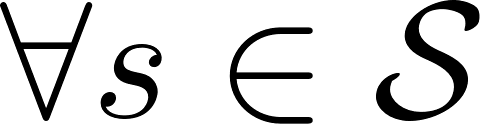
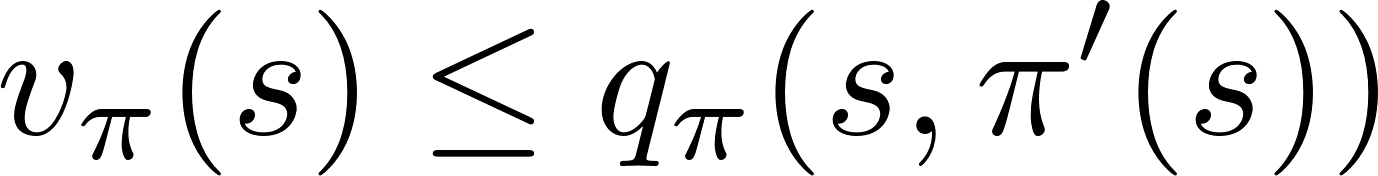
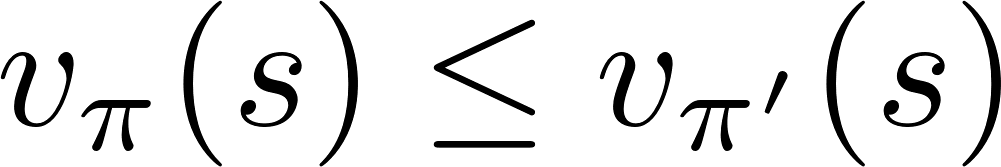
Value Iteration
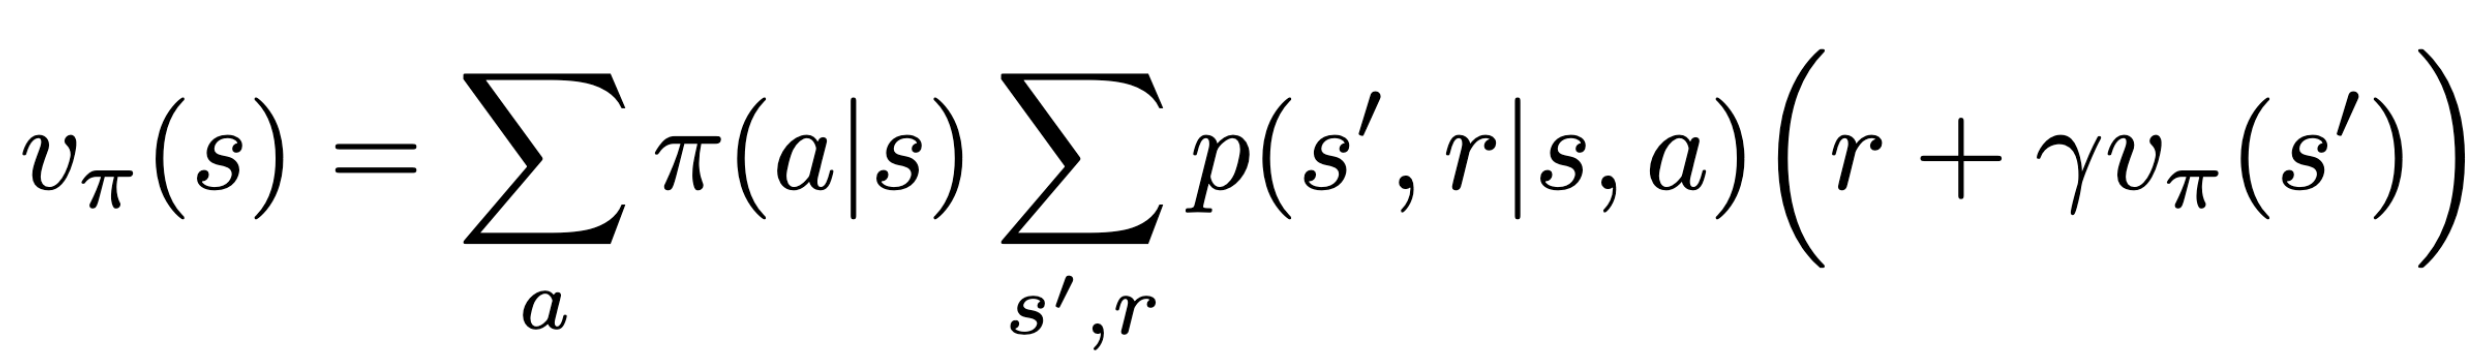
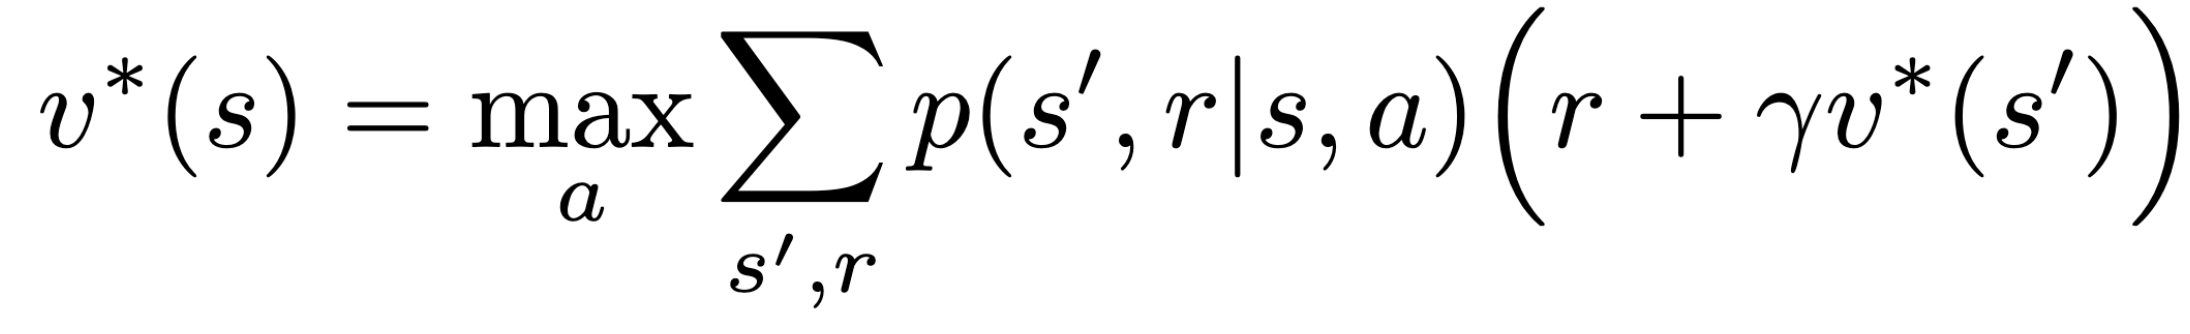
Bellman optimality equation
Bellman expectation equation
Policy Evaluation
Value Iteration
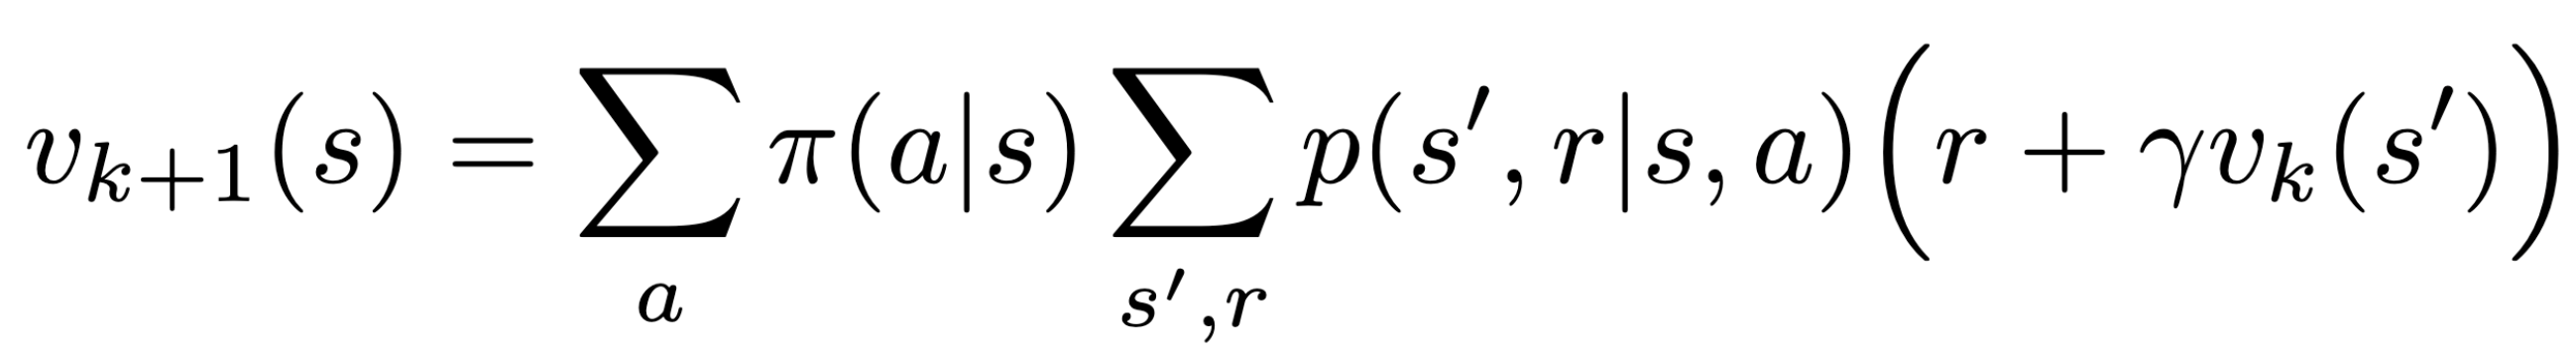
Turn into an
update rule
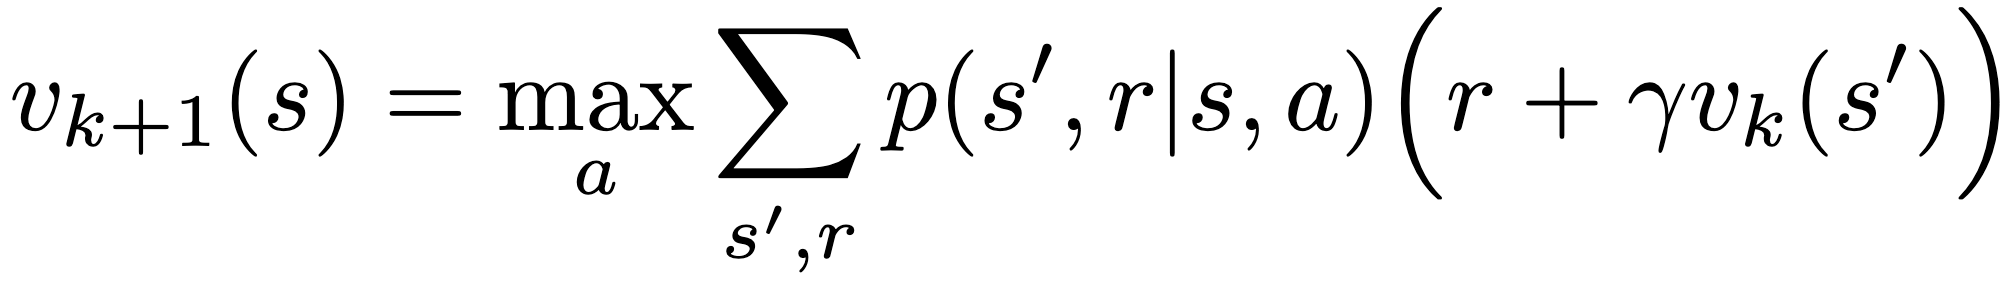
Turn into an
update rule
Equivalent to policy iteration, with step of policy
evaluation between each two (greedy) policy
improvement steps.
Generalized Policy Iteration (GPI)
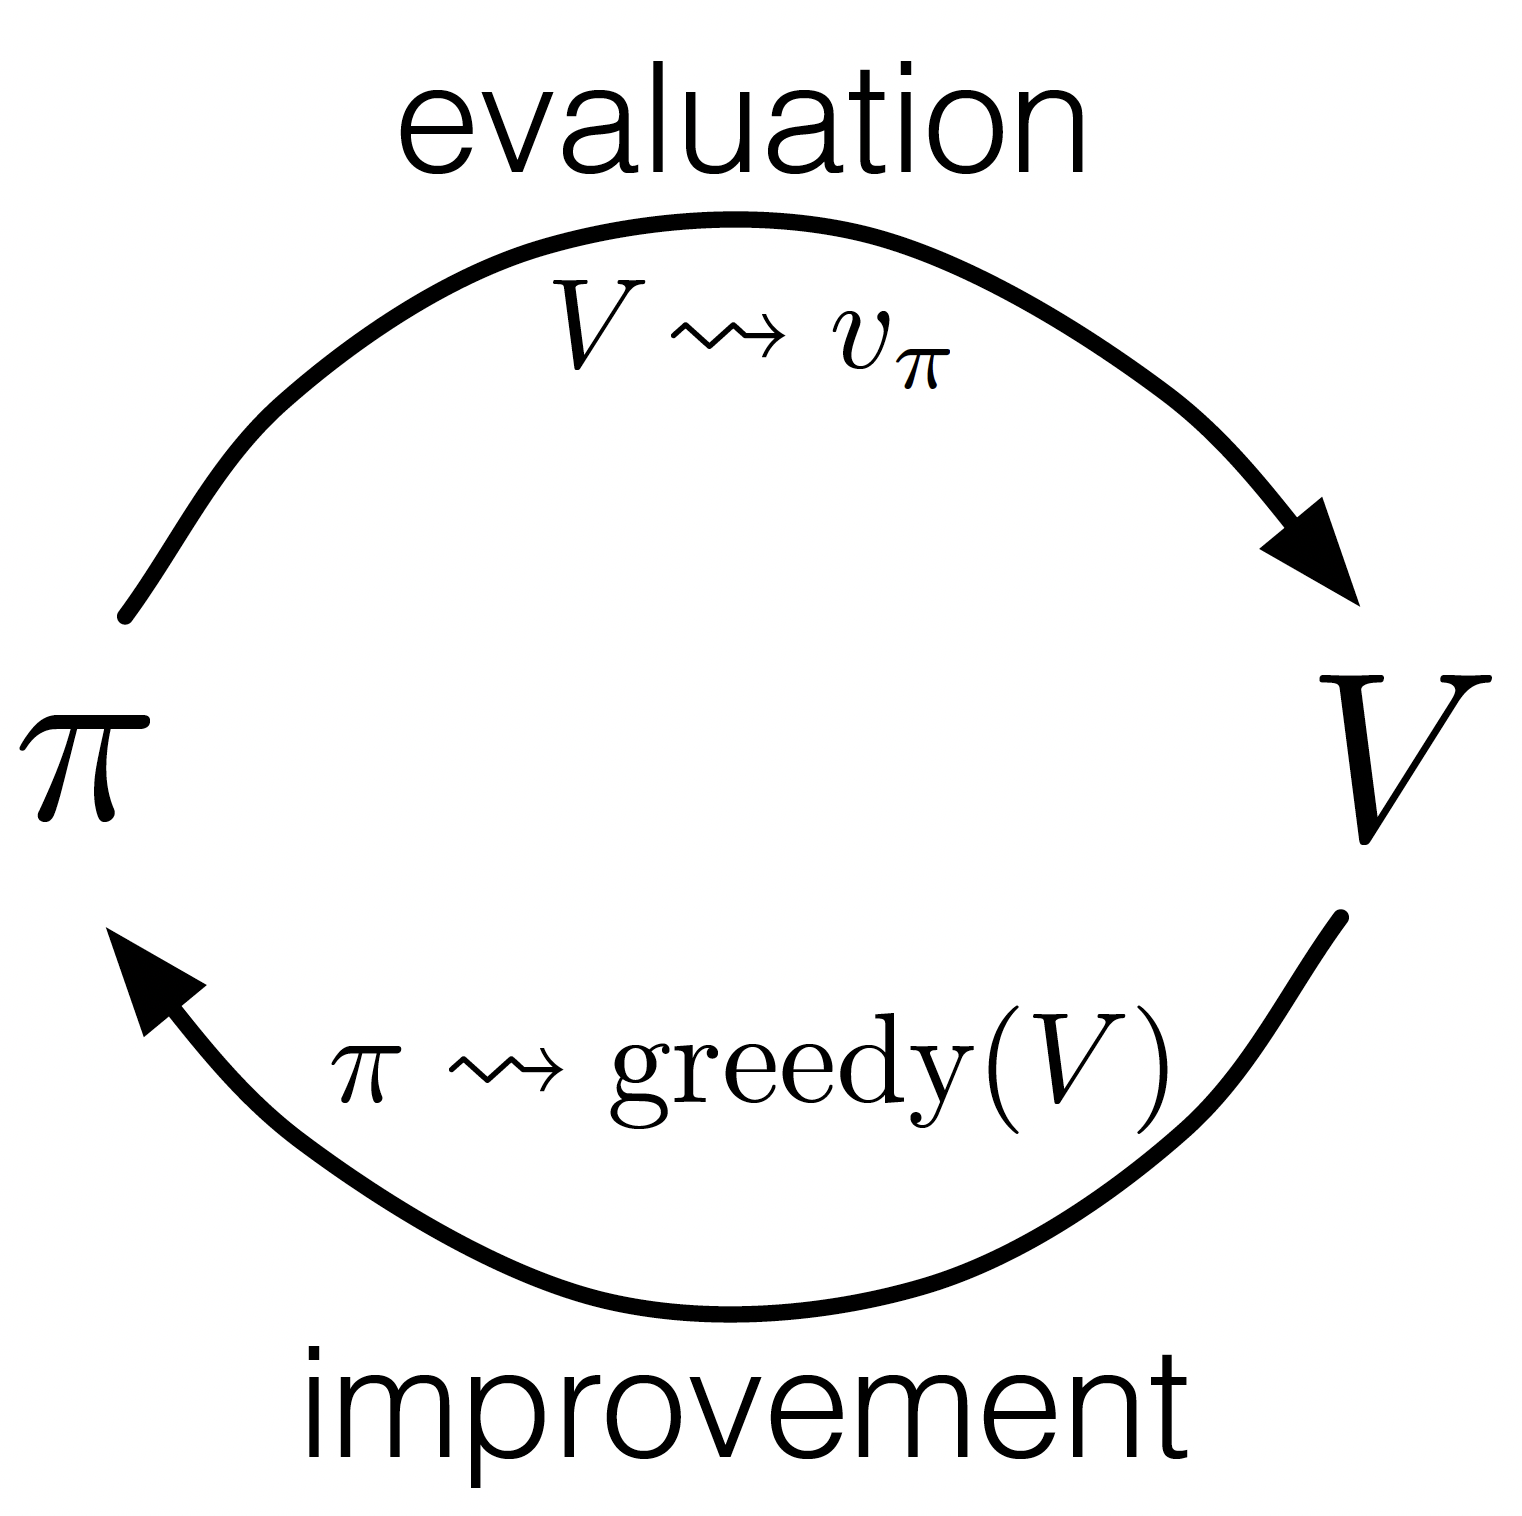
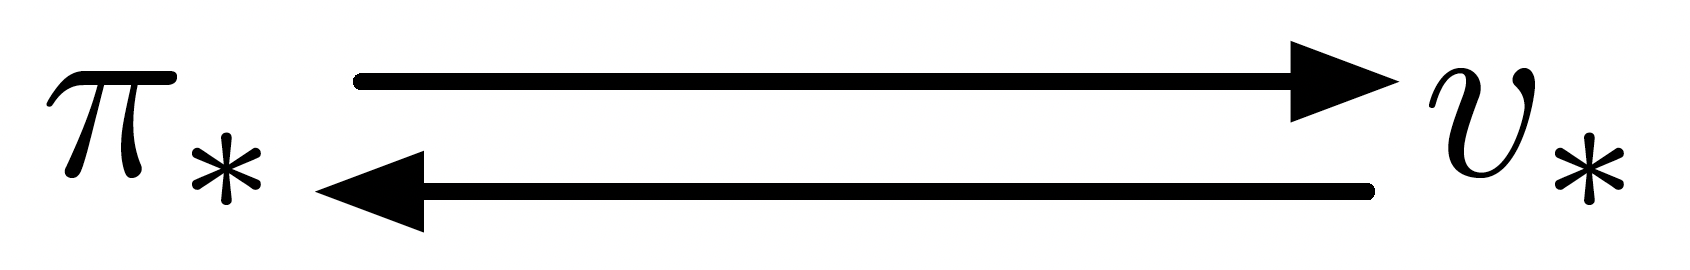
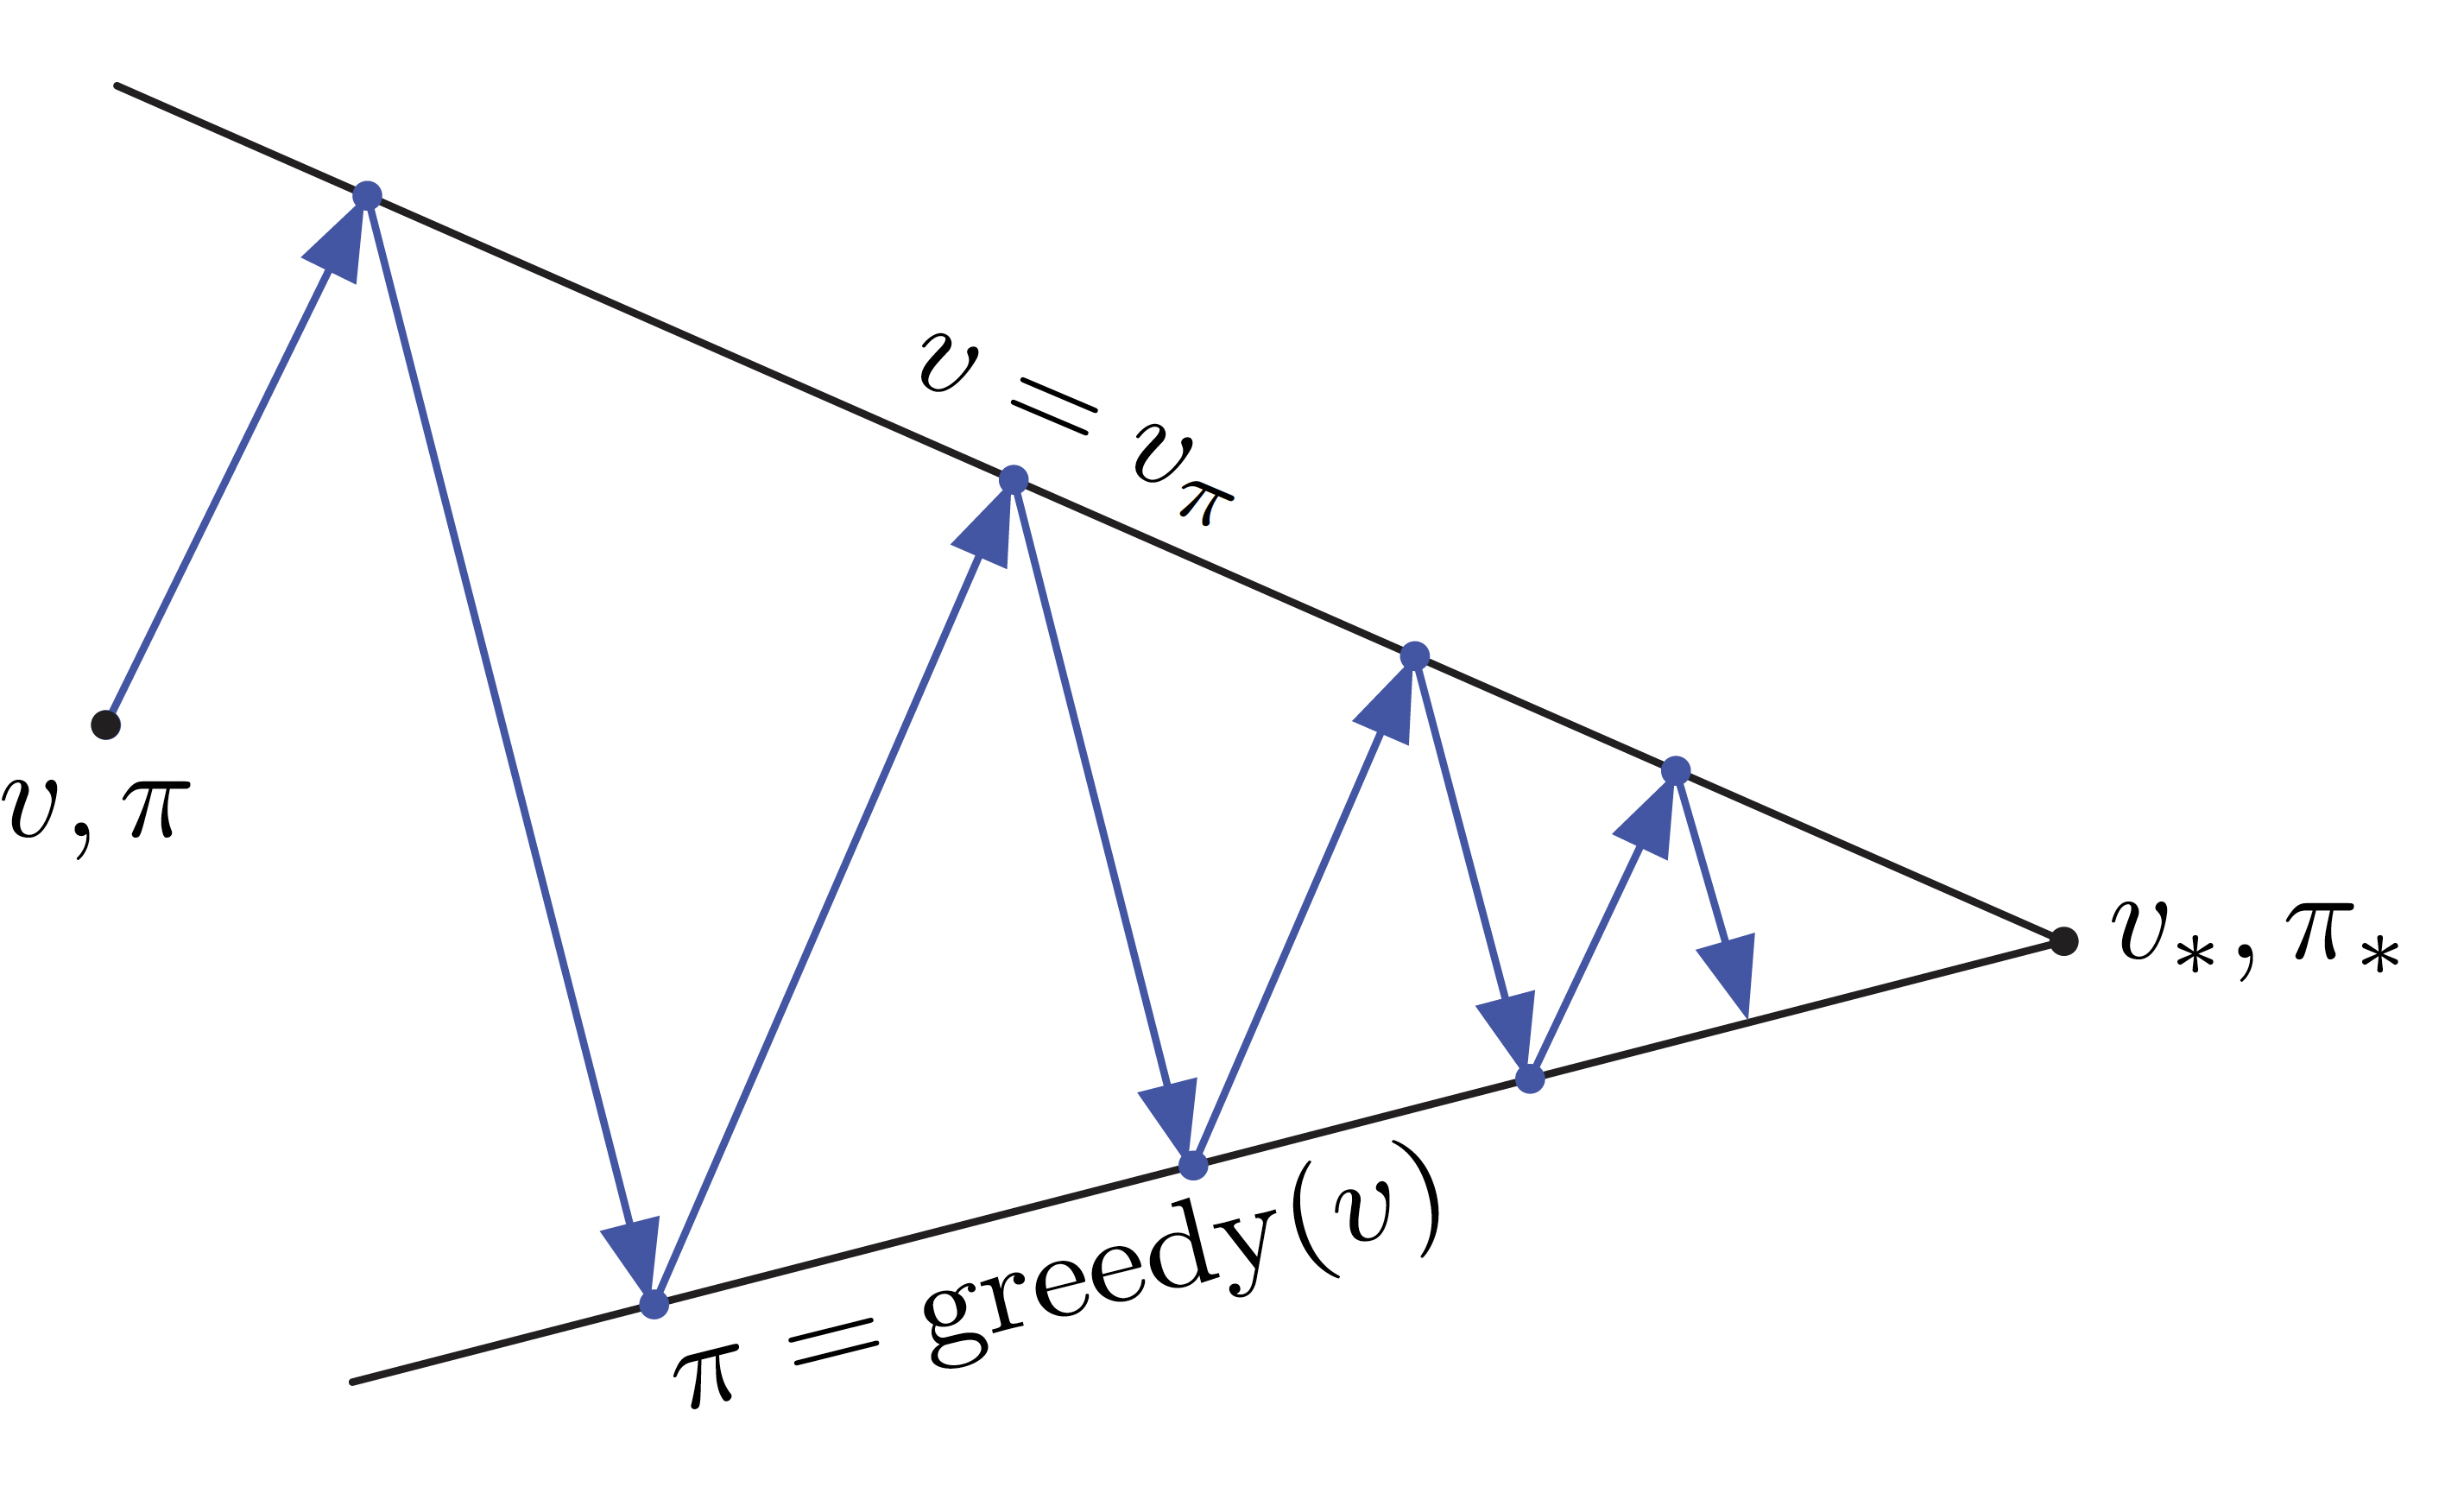
Alternating with some chosen iterations.
If both process converge,
the value function and
policy must be optimal.
Almost all RL methods are
well described as GPI
All have identifiable policies
and value functions
Policy being improved with
respect to the value function
Value function been driven toward
the value function for the policy.
Today’s Lecture
Solving the Bellman Optimality Equation
➢Many iterative solution methods:
➢Using models / dynamic programming
➢Value iteration
➢Policy iteration
➢Using samples (Model-free)
➢Prediction: Estimate the value function of an unknown MDP
➢Monte Carlo first/every visit
➢TD-learning (TD(0), n-step TD, TD())
➢Control: Optimize the value function of an unknown MDP
➢Monte Carlo exploring starts
➢SARSA, Q-learning, etc
➢DQN
Sampling vs Expectation
Consider a random variable X that can take values from a finite set of real numbers denoted by
Goal: Calculate the expected value of X.
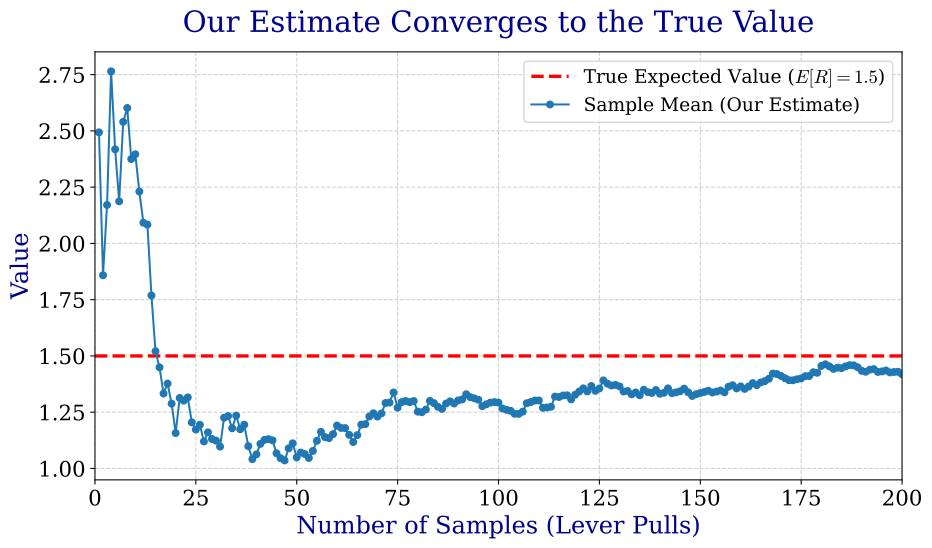
Recall the Multi-Armed Bandit problem
Model-based (Expected Value)
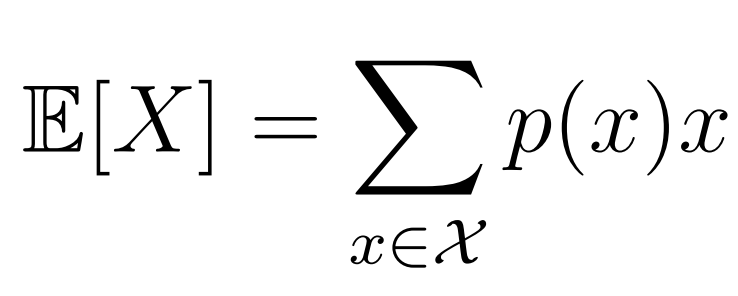
![\begin{align*}
\mathbb{E}[X] = \sum_{x \in \mathcal{X}} p(x) x
\end{align*}](media/e331a1b052.png)
Model-free (Sample Mean)
We sample from X:
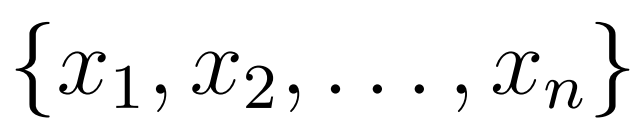
![\begin{align*}
\mathbb{E}[X] \approx \bar{x} = \frac{1}{n} \sum_{j=1}^{n} x_j
\end{align*}](media/d1a944f1c3.png)
Monte Carlo Algorithm
➢We can use experience samples to learn without a model
➢We call direct sampling of episodes Monte Carlo
➢MC is model-free: no knowledge of MDP required, only samples
What does it mean “without
a model” here?
MDP
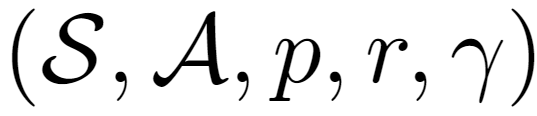
Relationship between Monte Carlo and Bandits
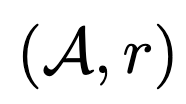

MDP
Bandit
What does it mean
“without a model”
here?
How do we estimate the action
function in the bandit problem?
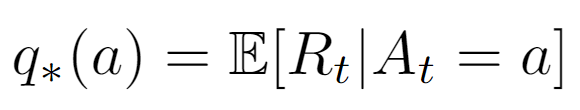
![\begin{align*}
q_*(a) = \mathbb{E}[R_t | A_t = a]
\end{align*}](media/7713a4f661.png)
Action Value
We sample rewards from a reward
distribution, and use an update rule.
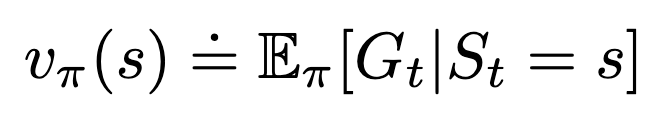
![\begin{align*}
v_\pi(s) \doteq \mathbb{E}_\pi[G_t | S_t = s]
\end{align*}](media/411fd968ea.png)

How do we estimate the state-value function in the MDP
problem?
We sample trajectories from an MDP, and use an update rule!
Incremental Implementation
![\begin{align*}
Q_{n+1}(a) = Q_n(a) + \alpha_n(a) \Big[R_n - Q_n(a)\Big]
\end{align*}](media/870706deab.png)

Relationship between Monte Carlo and Bandits


MDP
Bandit
What does it mean
“without a model”
here?
How do we estimate the action
function in the bandit problem?
![\begin{align*}
q_*(a) = \mathbb{E}[R_t | A_t = a]
\end{align*}](media/7713a4f661.png)
Action Value
We sample rewards from a reward
distribution, and use an update rule.
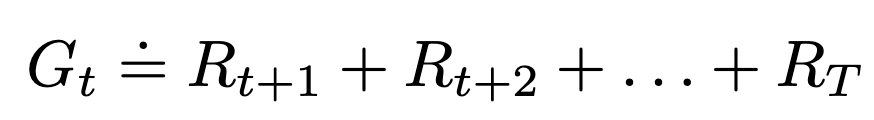
![\begin{align*}
v_\pi(s) \doteq \mathbb{E}_\pi[G_t | S_t = s]
\end{align*}](media/411fd968ea.png)

How do we estimate the state-value function in the MDP
problem?
We sample trajectories from an MDP, and use an update rule!

Incremental Implementation
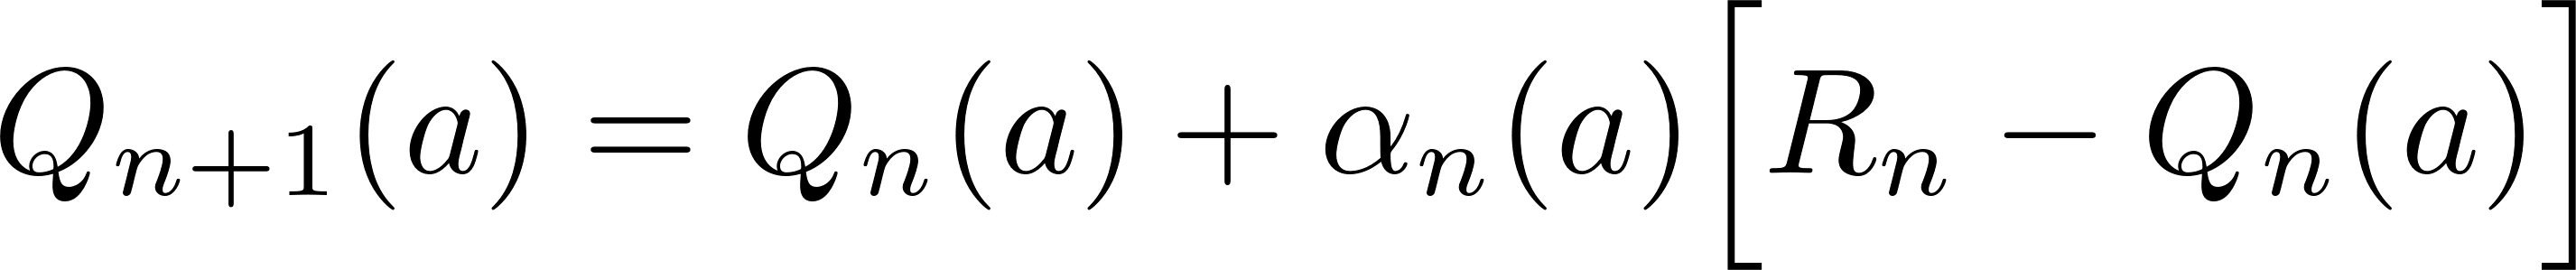
![\begin{align*}
Q_{n+1}(a) = Q_n(a) + \alpha_n(a) \Big[R_n - Q_n(a)\Big]
\end{align*}](media/870706deab.png)
NewEstimate
OldEstimate
StepSize
Informative
Value


Error
Error
Model-Free Prediction: Monte Carlo Algorithms
Monte-Carlo Policy Evaluation
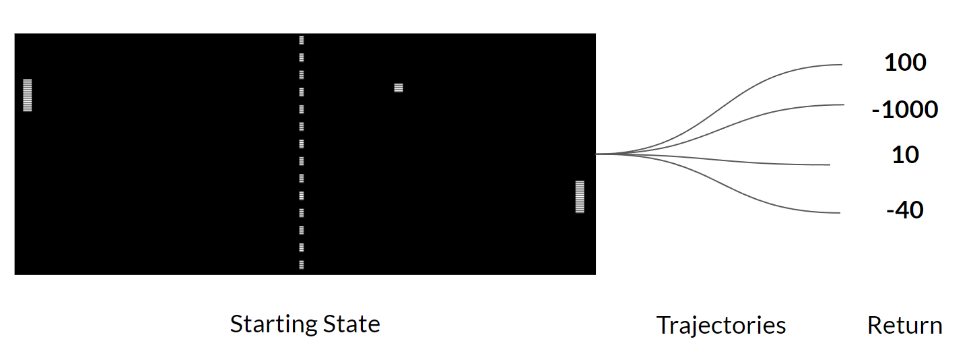
➢With MDP’s, we are considering sequential decision problems.
➢Goal: Learn or from episodes of experience under policy .

➢The value function is the expected return from each state:
![\begin{align*}
v_\pi(s) \doteq \mathbb{E}_\pi[G_t | S_t = s]
\end{align*}](media/411fd968ea.png)
➢We can just use the sample mean return instead of the expected return.
➢We call this Monte Carlo policy evaluation.
Monte-Carlo prediction (first-visit)
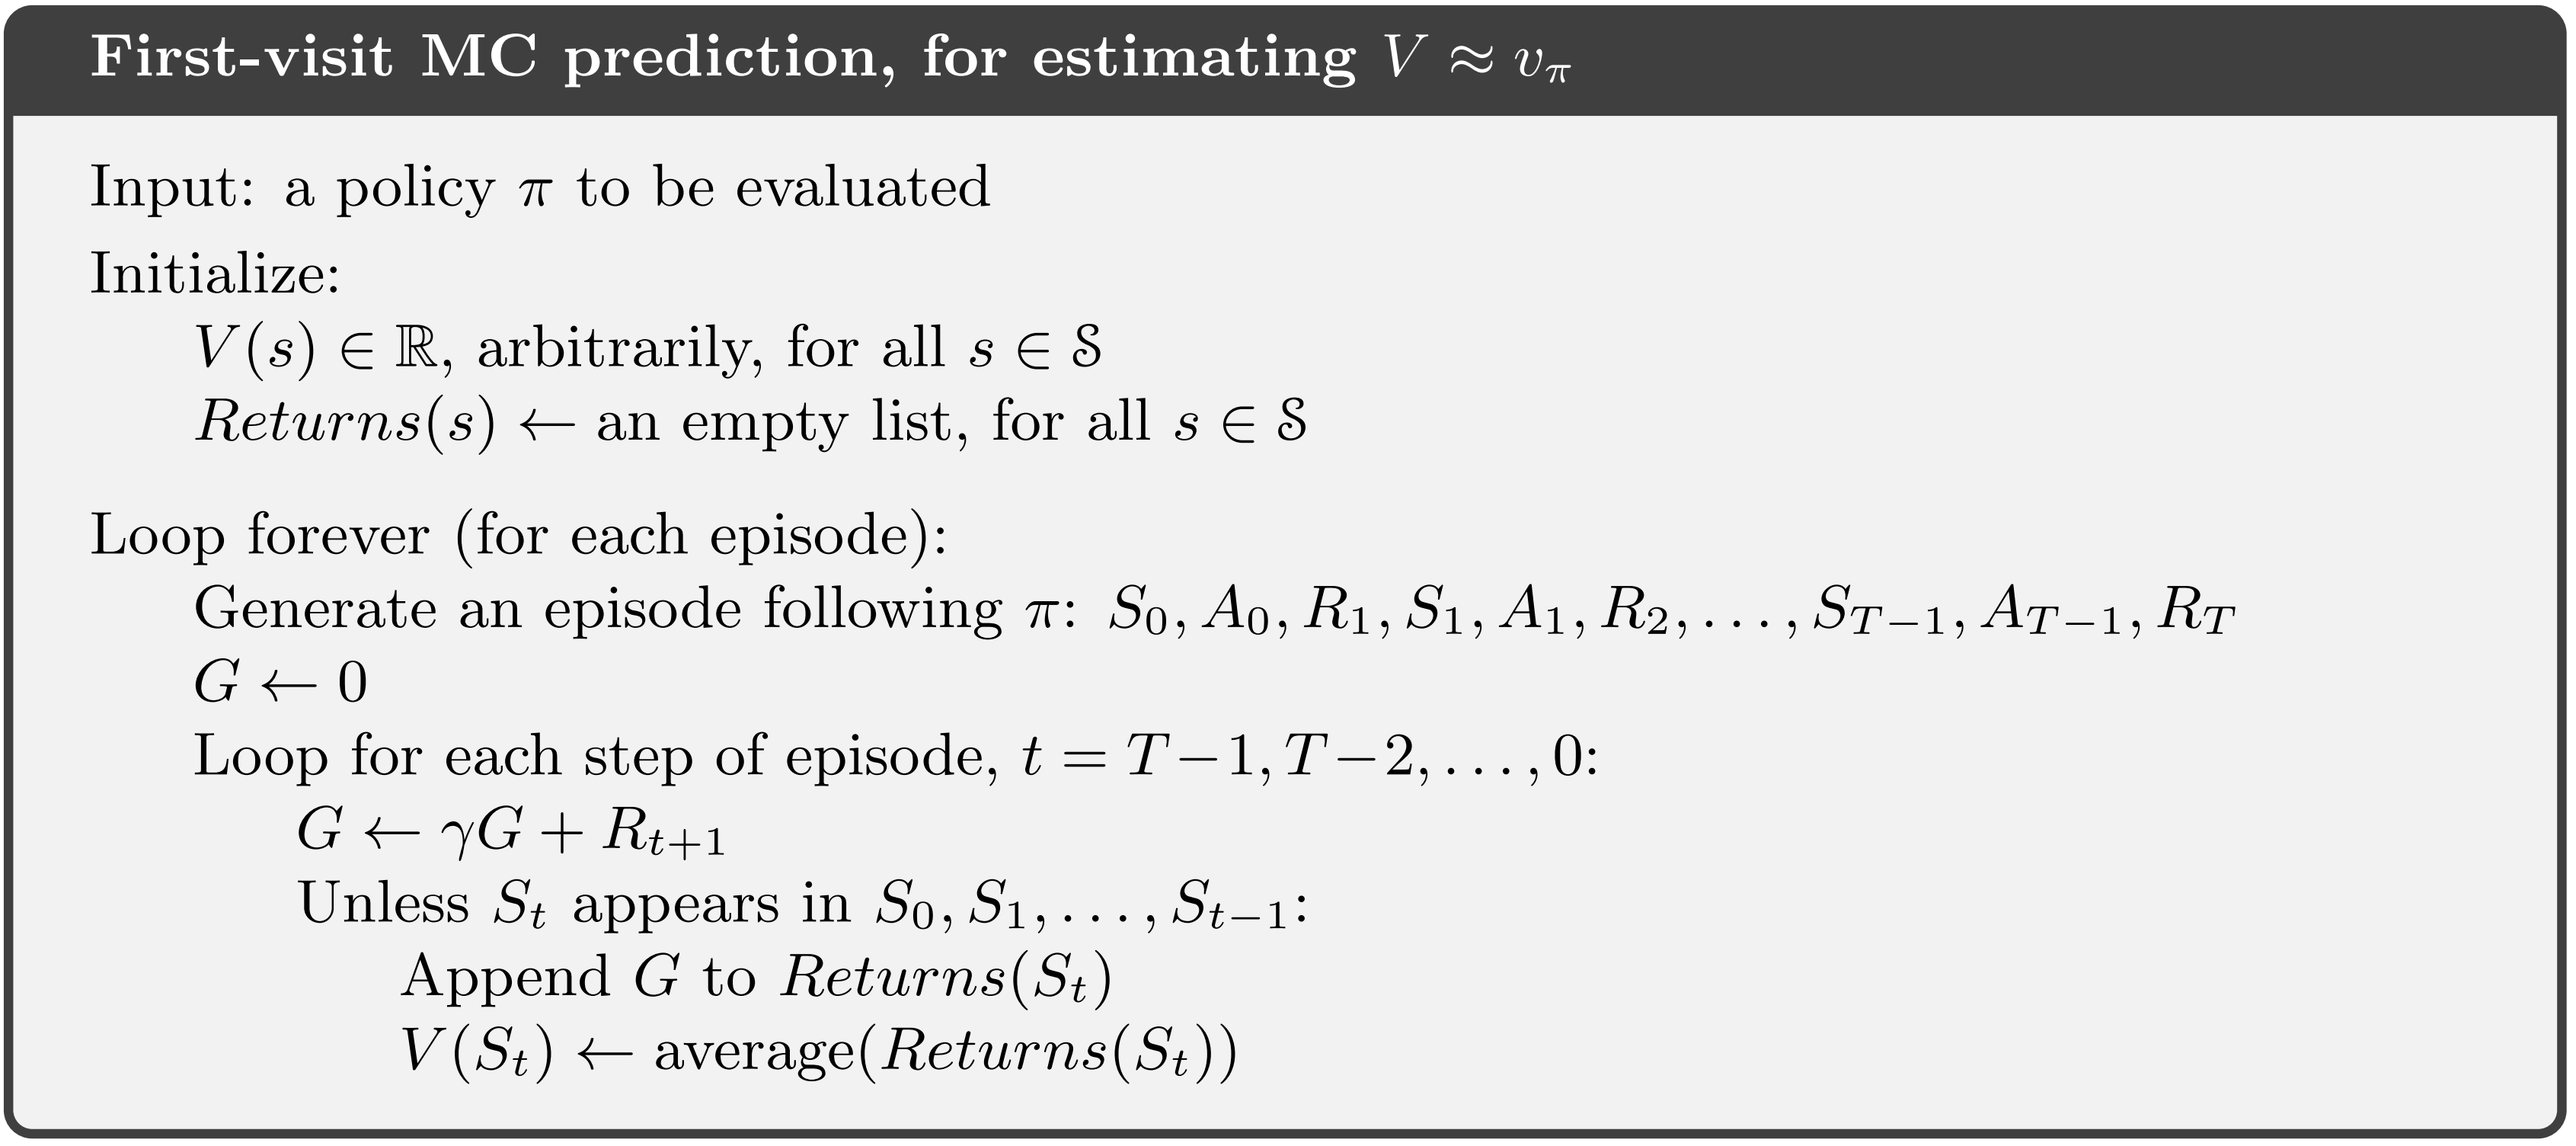
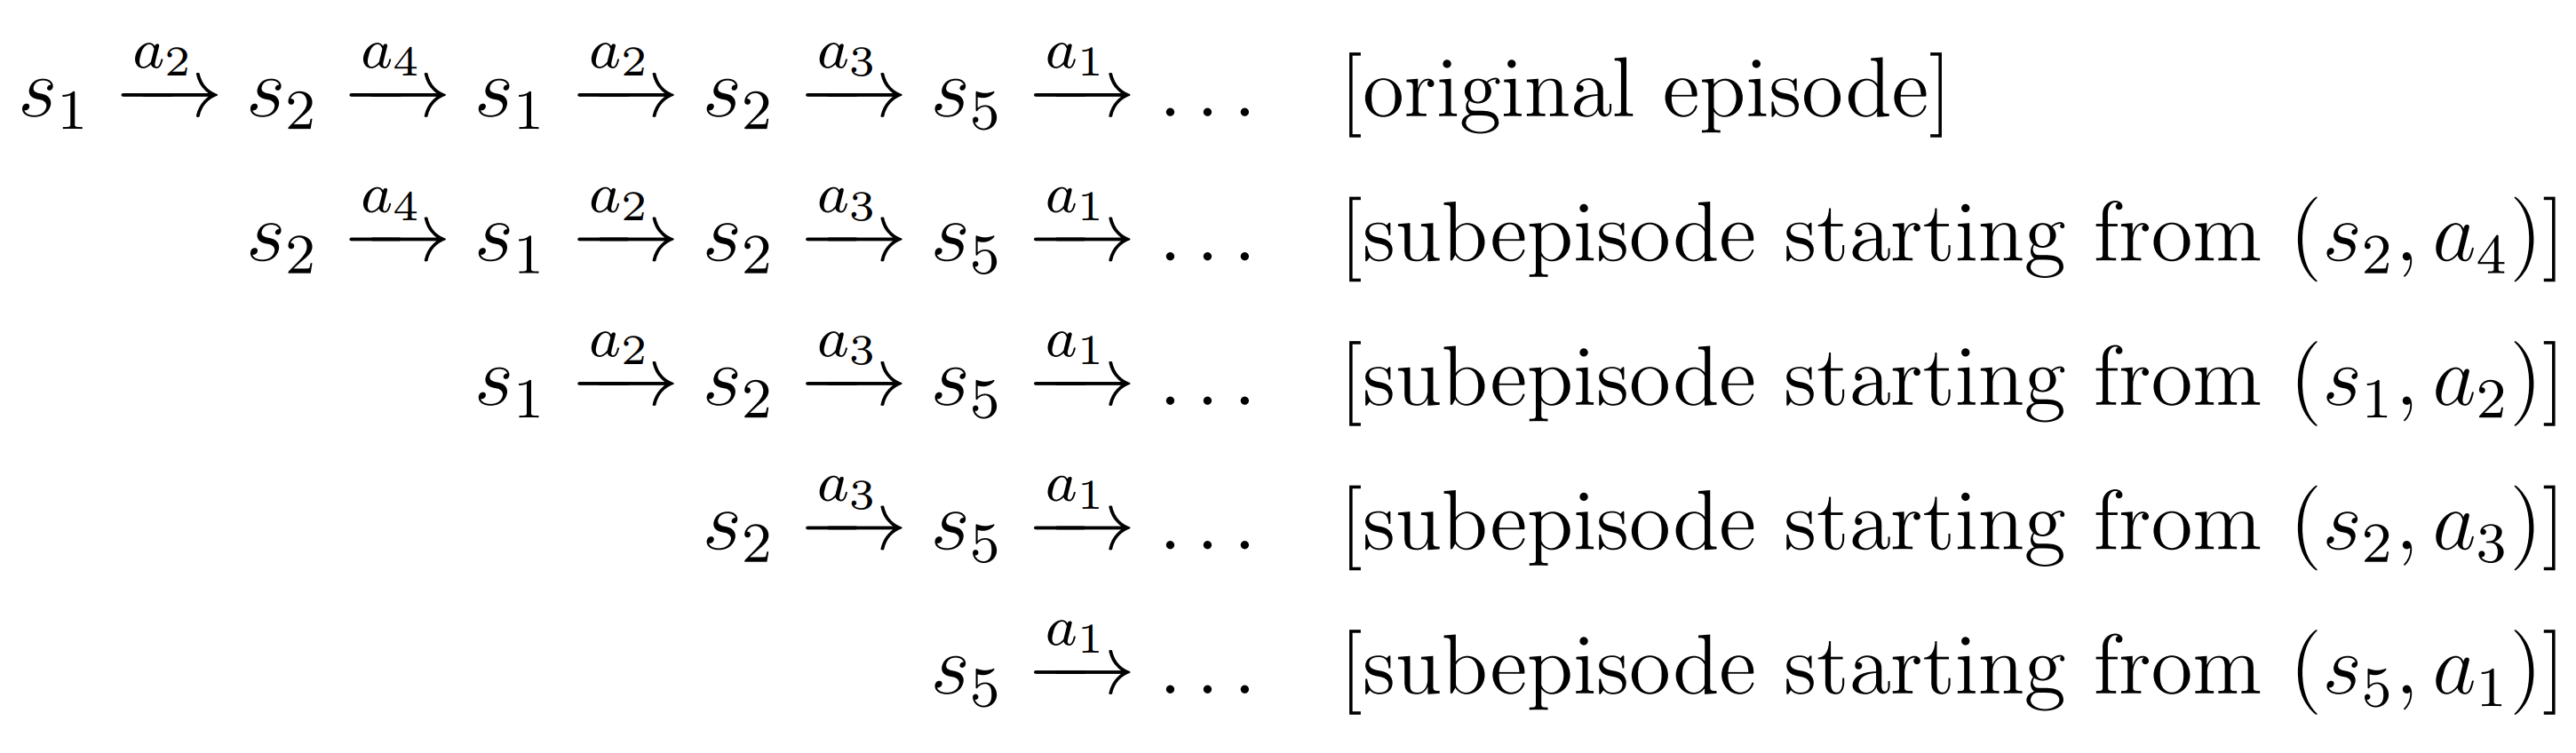
MC First-visit vs Every visit
![\begin{align*}
s_1 \xrightarrow{a_2} s_2 \xrightarrow{a_4} s_1 \xrightarrow{a_2} s_2 \xrightarrow{a_3} s_5 \xrightarrow{a_1} \ldots &\quad [\text{original episode}] \\ s_2 \xrightarrow{a_4} s_1 \xrightarrow{a_2} s_2 \xrightarrow{a_3} s_5 \xrightarrow{a_1} \ldots &\quad [\text{subepisode starting from } (s_2, a_4)] \\ s_1 \xrightarrow{a_2} s_2 \xrightarrow{a_3} s_5 \xrightarrow{a_1} \ldots &\quad [\text{subepisode starting from } (s_1, a_2)] \\ s_2 \xrightarrow{a_3} s_5 \xrightarrow{a_1} \ldots &\quad [\text{subepisode starting from } (s_2, a_3)] \\ s_5 \xrightarrow{a_1} \ldots &\quad [\text{subepisode starting from } (s_5, a_1)]
\end{align*}](media/0a55ae880c.png)
Remove the “Unless appears in the previous states” condition.
Monte-Carlo prediction (first-visit)

Every-visit
Example: Blackjack
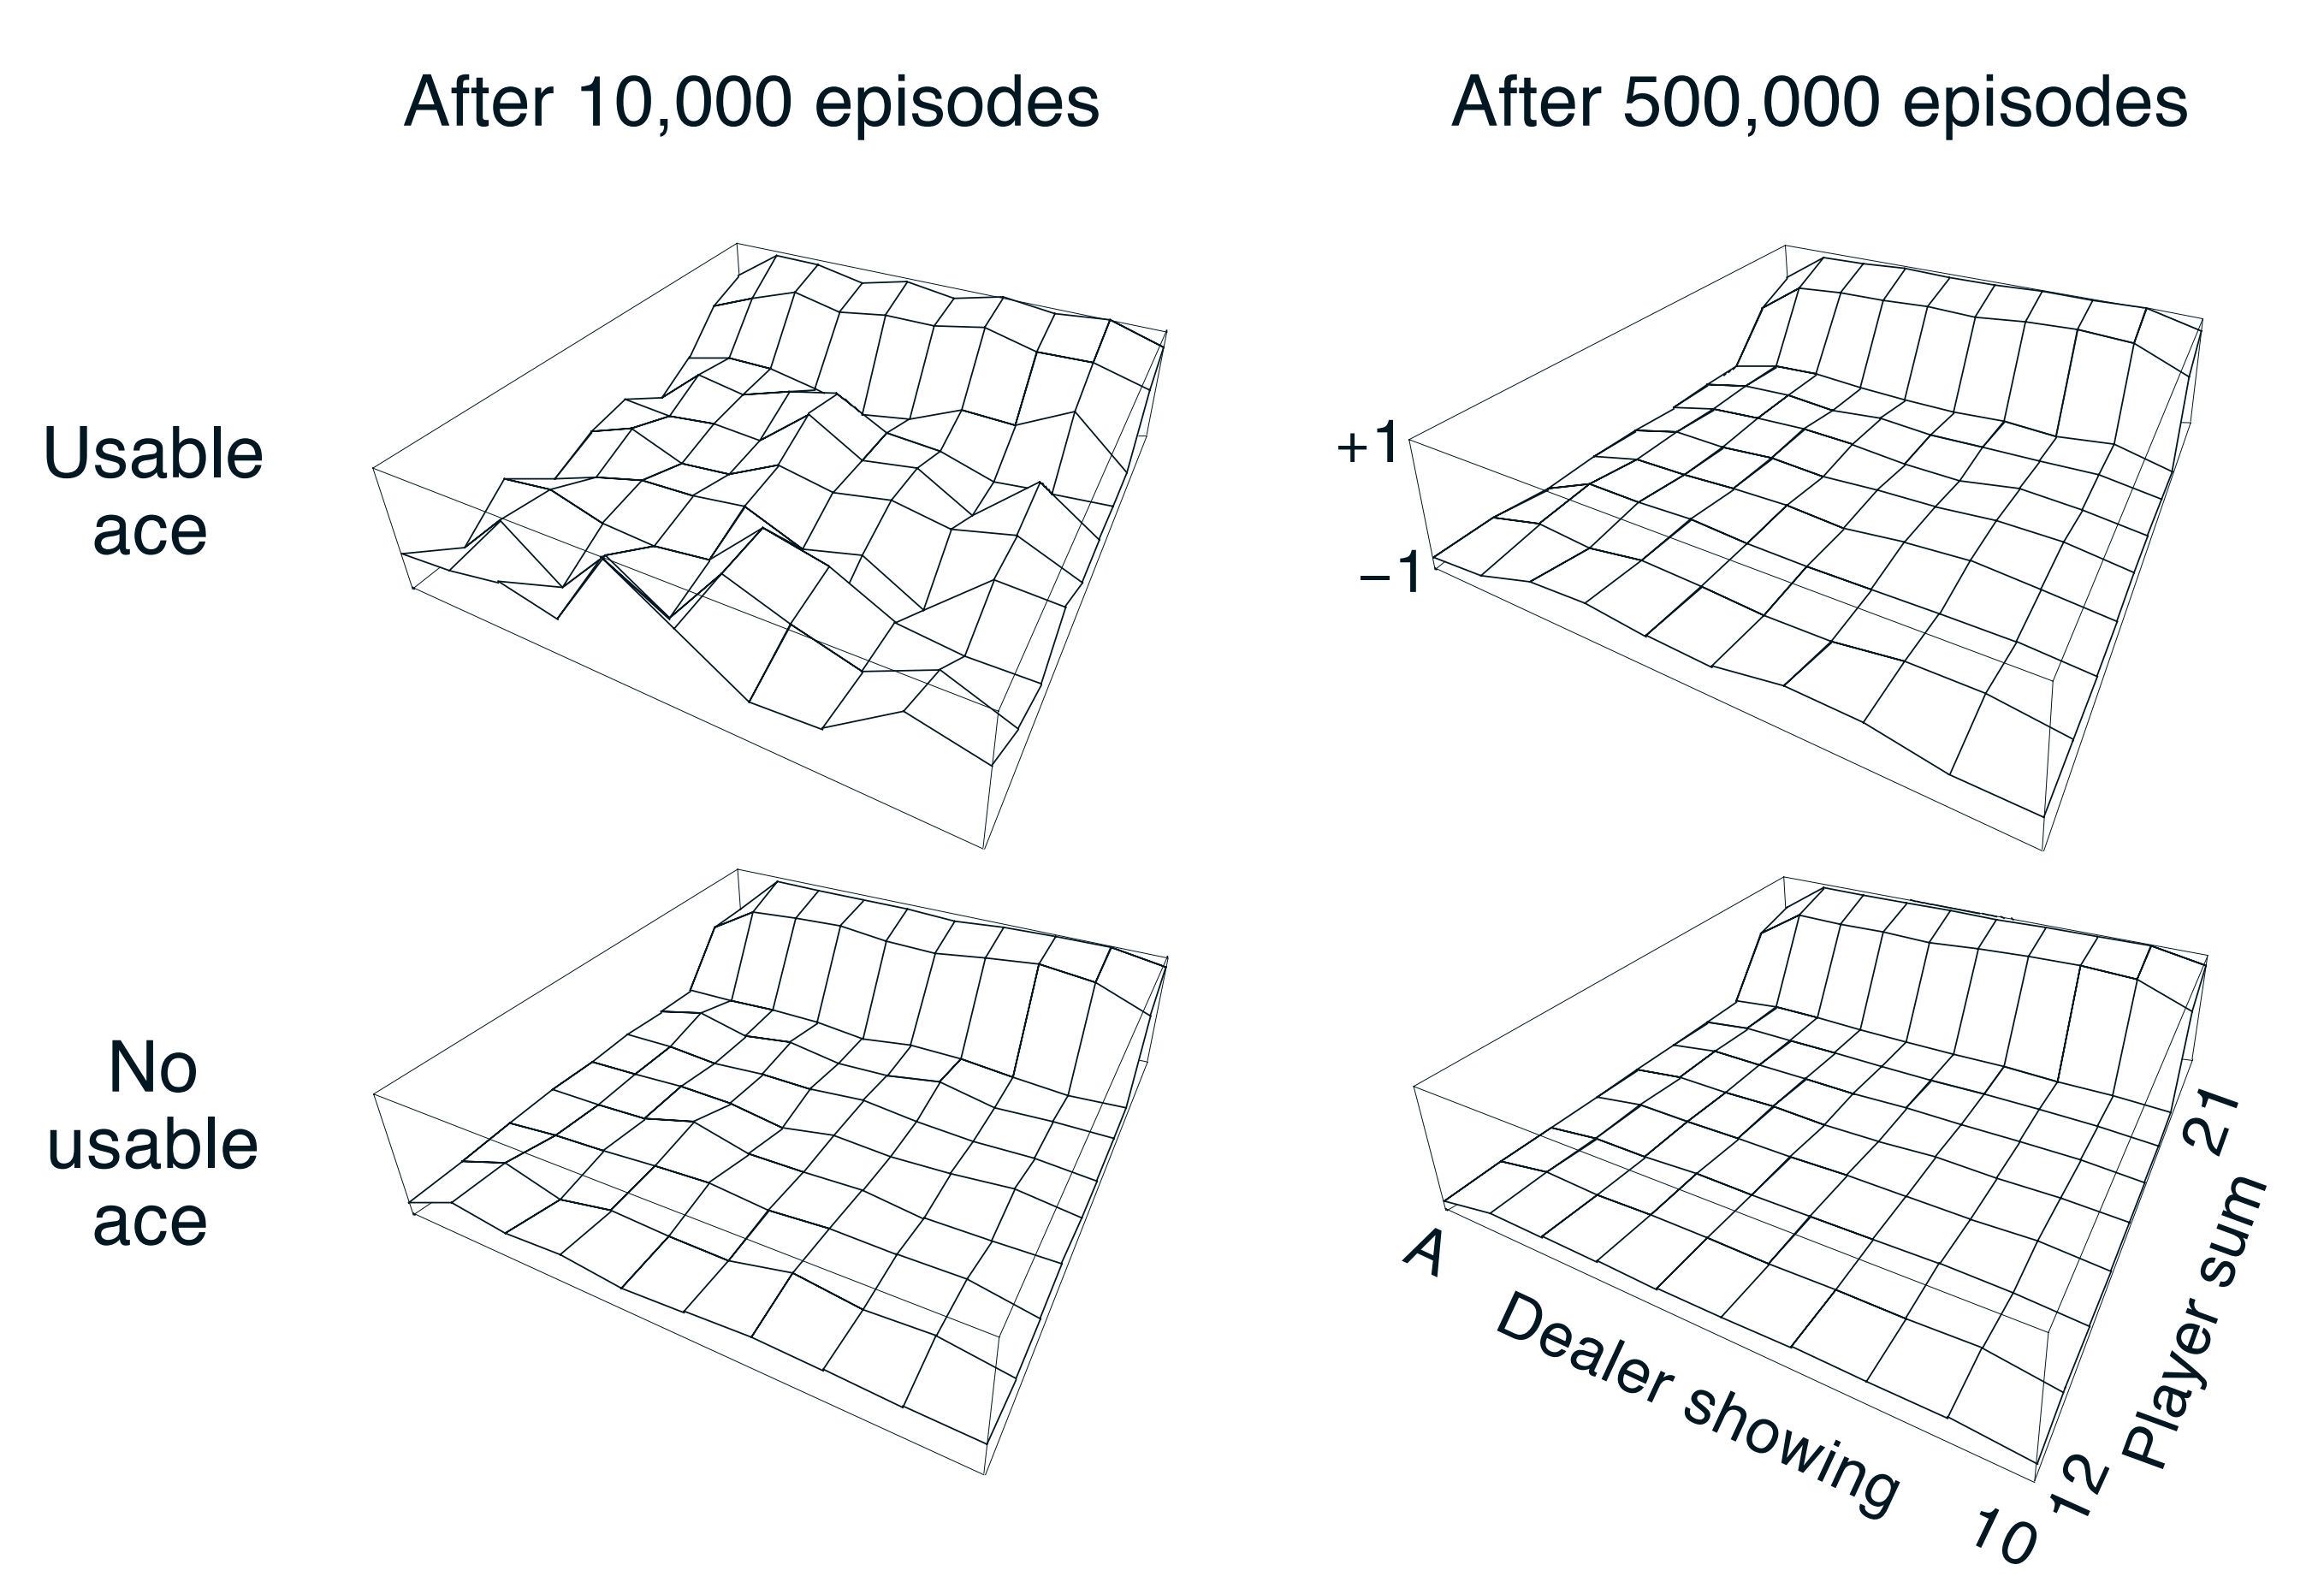
➢State Space:
➢Current sum (12-21)
➢Dealer’s showing card (ace-10)
➢Do I have a “usable” ace? (yes-no)
➢Action Space = {stick, draw}
➢Reward function:
➢for stick:
➢+1 if sum of cards > sum of dealer cards
➢0 if sum of cards = sum of dealer cards
➢-1 if sum of cards < sum of dealer cards
➢for draw:
➢-1 if sum of cards > 21 (and terminate)
➢0 otherwise
➢Transition function:
➢Automatically draw if sum of cards < 12
➢Next card randomly sampled from a deck.
Stop receiving cards (and terminate)
Take another card (random, no replacement)
Example: Blackjack

Disadvantage of Monte-Carlo Learning
➢We have seen that MC algorithms can be used to learn value predictions
➢But when episodes are long, learning can be slow
➢...we have to wait until an episode ends before we can learn
➢...return can have high variance
Are there alternatives?
Temporal Difference Learning by Sampling Bellman Equations
Bellman Equations
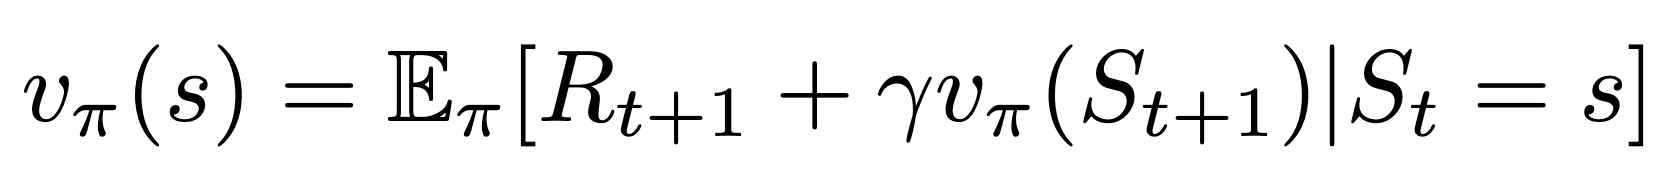
![\begin{align*}
v_\pi(s) = \mathbb{E}_\pi[R_{t+1} + \gamma v_\pi(S_{t+1}) | S_t = s]
\end{align*}](media/d3471597ad.png)
Policy Evaluation (Iterative)
![\begin{align*}
v_{k+1}(s) = \mathbb{E}_\pi[R_{t+1} + \gamma v_k(S_{t+1}) | S_t = s]
\end{align*}](media/76ce9c5506.png)
Sample this equation!

What are possible problems with this approach?
Changes are very abrupt! Use update rule with a small step-size.
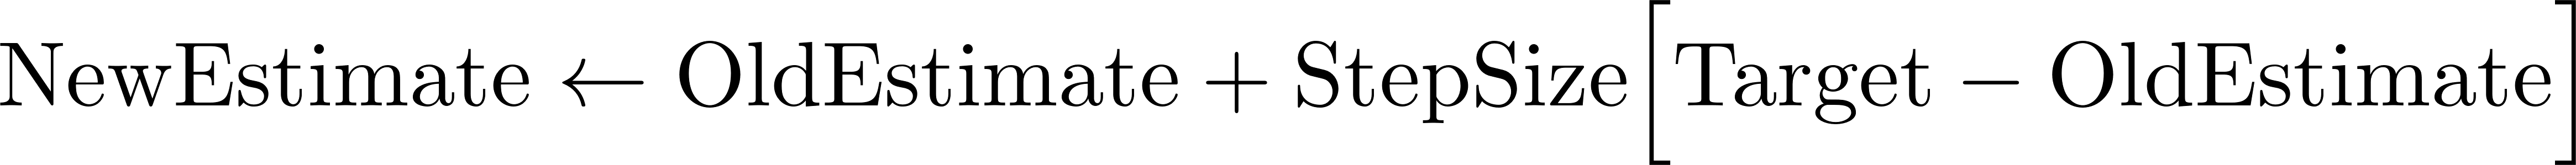
![\begin{align*}
\text{NewEstimate} \leftarrow \text{OldEstimate} + \text{StepSize} \Big [ \text{Target} - \text{OldEstimate} \Big ]
\end{align*}](media/60a39998a5.png)
![\begin{align*}
\text{NewEstimate} \leftarrow \text{OldEstimate} + \text{StepSize} \Big [ \text{Target} - \text{OldEstimate} \Big ]
\end{align*}](media/60a39998a5.png)

Temporal Difference Learning by Sampling Bellman Equations

Target
Time-difference error
Error in the estimate!
Reduced by taking a step toward the “target”
Temporal difference learning
Prediction setting: learn online from experience under policy
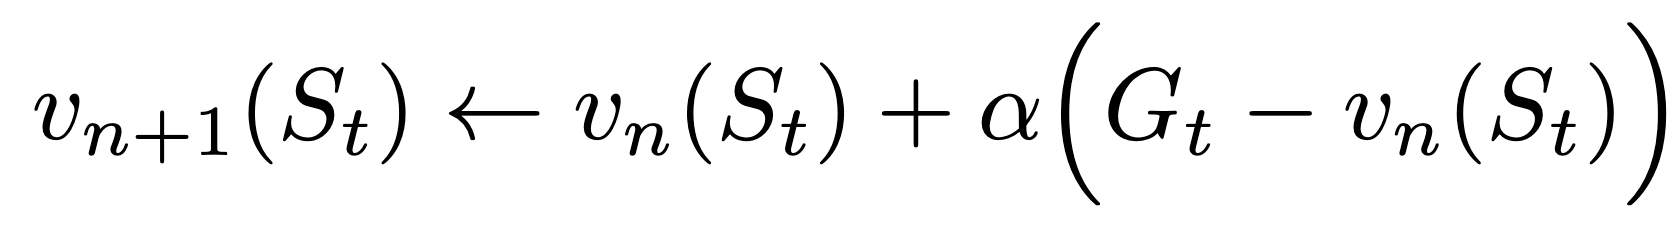
Monte-Carlo
Update value towards sampled returns

Temporal-difference learning:
Update value towards estimated return
Target
Target
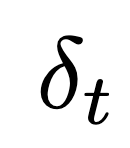


Temporal difference learning
Prediction setting: learn online from experience under policy
Monte-Carlo
Update value towards sampled returns
Temporal-difference learning:
Update value towards estimated return
TD error
TD(0) algorithm
![\renewcommand{\thealgorithm}{}
\begin{algorithm}
\caption{Tabular TD($0$) for estimating \(V \approx v_\pi\).}
\begin{algorithmic}[1]
\State Input: the policy $\pi$ to be evaluated
\State Algorithm parameters: step size \(\alpha \in (0, 1]\)
\State Initialize \(V(s)\), for all \(s \in \mathcal{S}^+\), arbitrarily except that \(V(\text{terminal}) = 0\) \\
\For{each episode}
\State Initialize \(S\)
\For{\(t=1, ..., T\) (until terminal state)}
\State $A \leftarrow$ action given by $\pi$ for $S$
\State Take action \(A\), observe \(R\), \(S'\)
\State \(\delta = R + \gamma V(S') - V(S)\)
\State \(V(s) \leftarrow V(s) + \alpha \delta \)
\State \(S \leftarrow S'\)
\EndFor
\EndFor
\label{tabular TD(lambda)}
\end{algorithmic}
\end{algorithm}](media/0dda5ddf38.png)
Dynamic Programming Backup
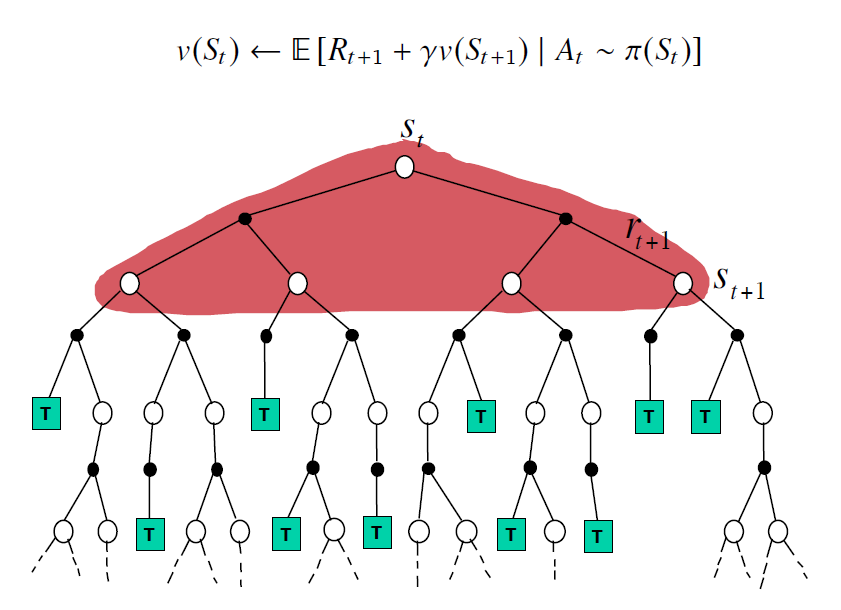
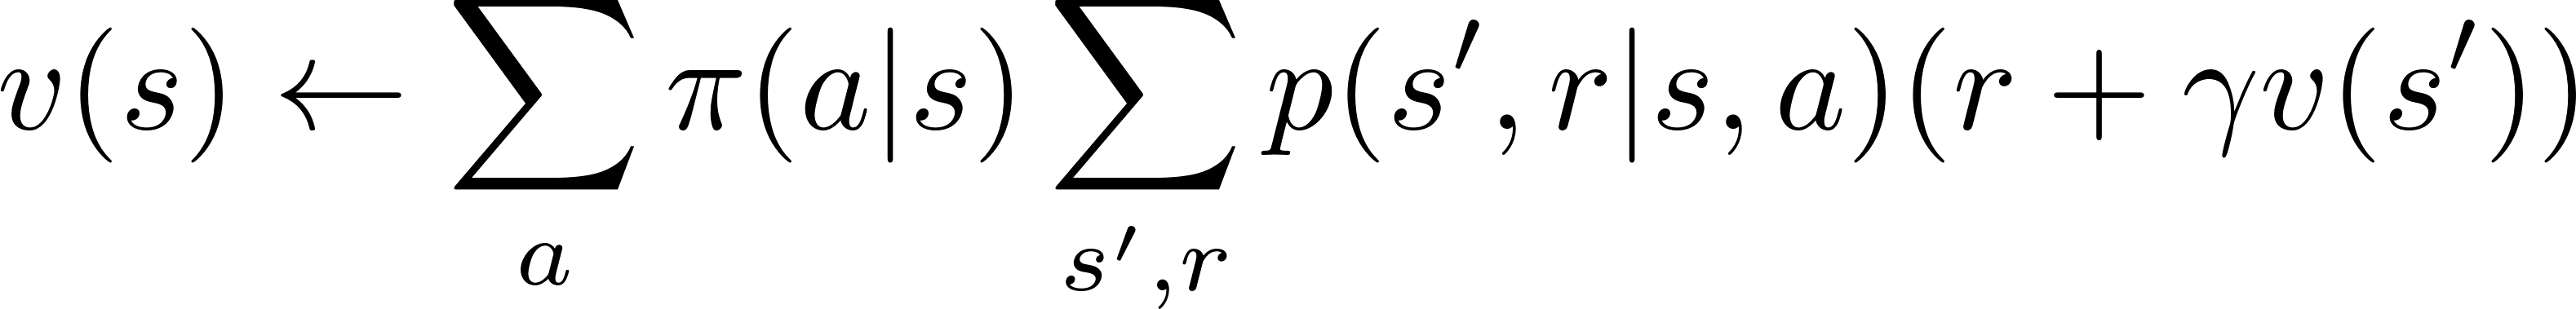
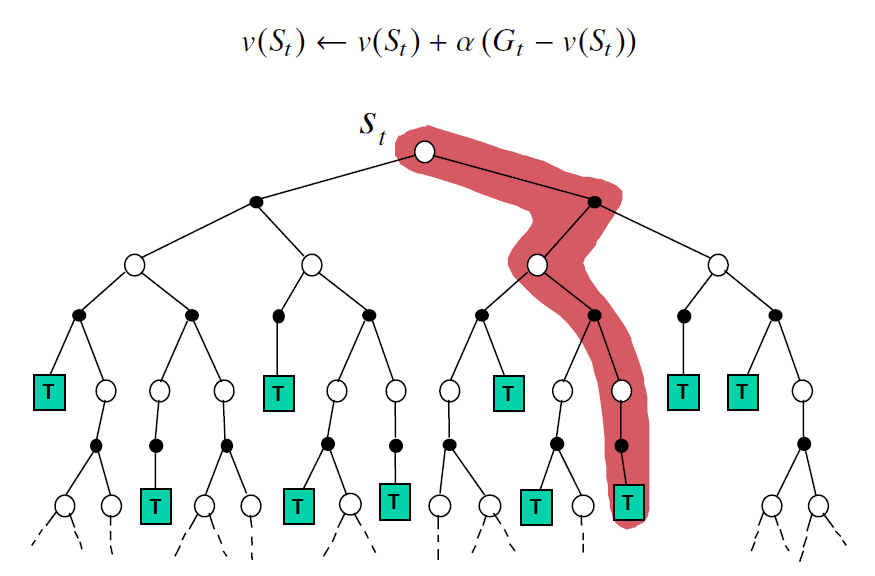
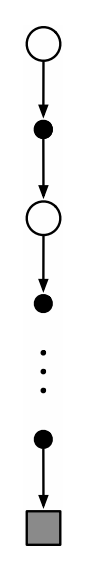
Monte-Carlo Backup
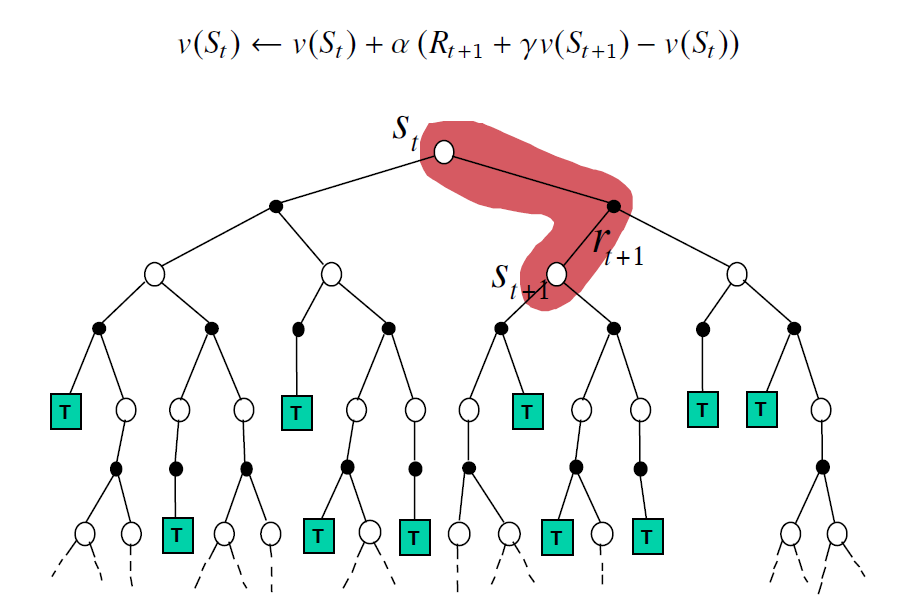
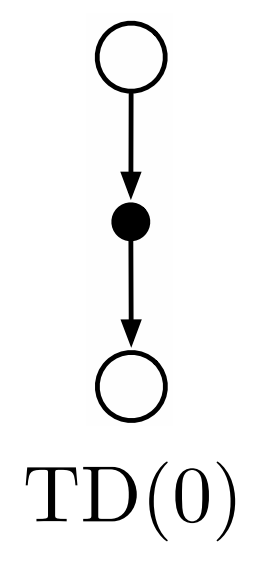
Temporal-Difference Backup
Sampling: update samples an expectation
Monte-Carlo
Dynamic Programming
Temporal-Difference learning
Bootstrapping: update involves an estimate
Monte-Carlo
Dynamic Programming
Temporal-Difference learning
Bootstrapping and Sampling
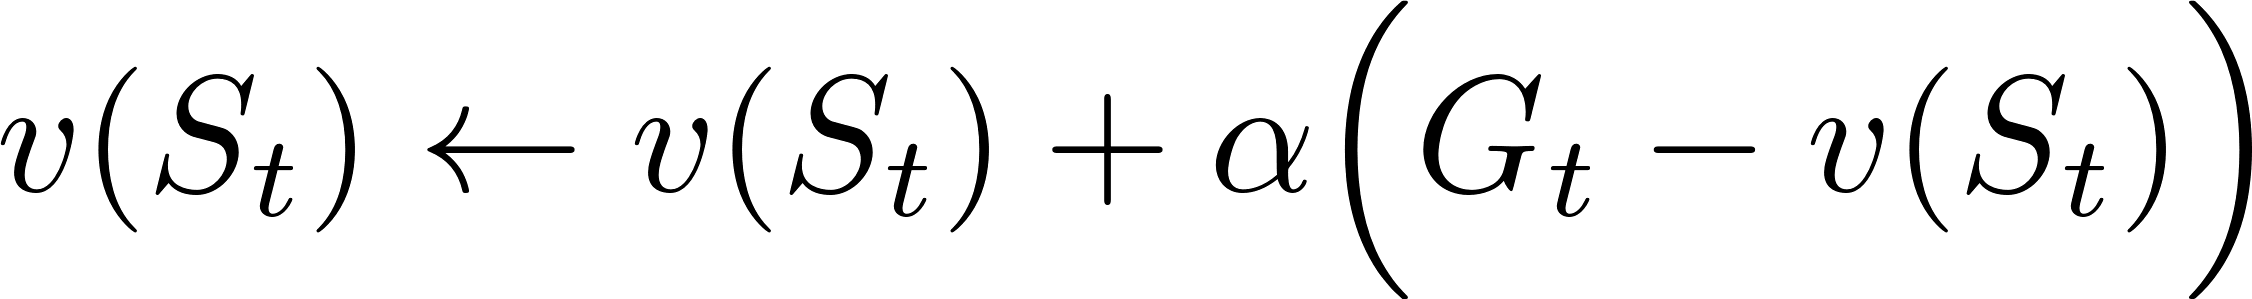
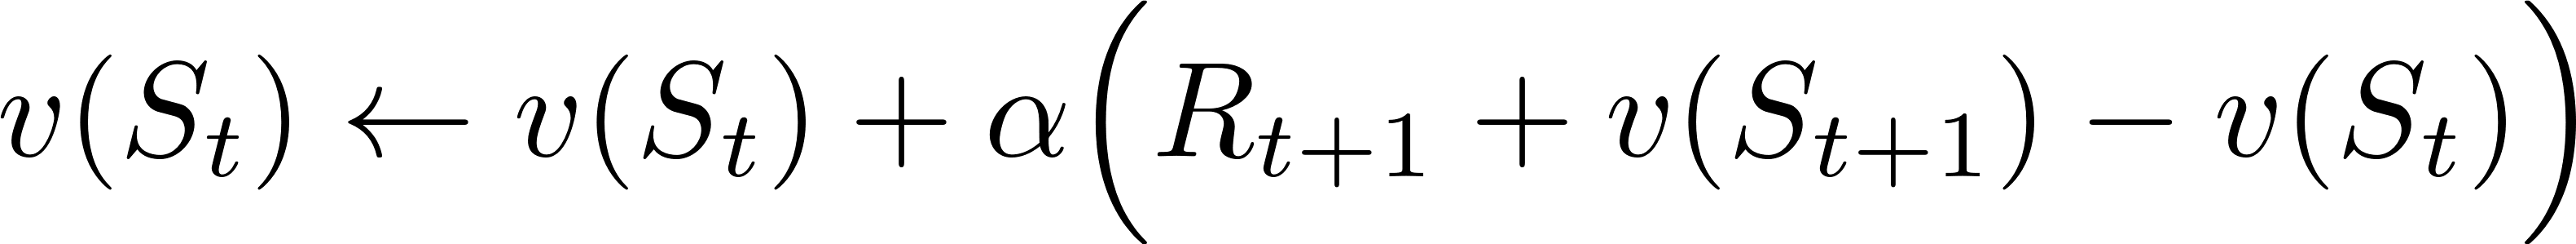
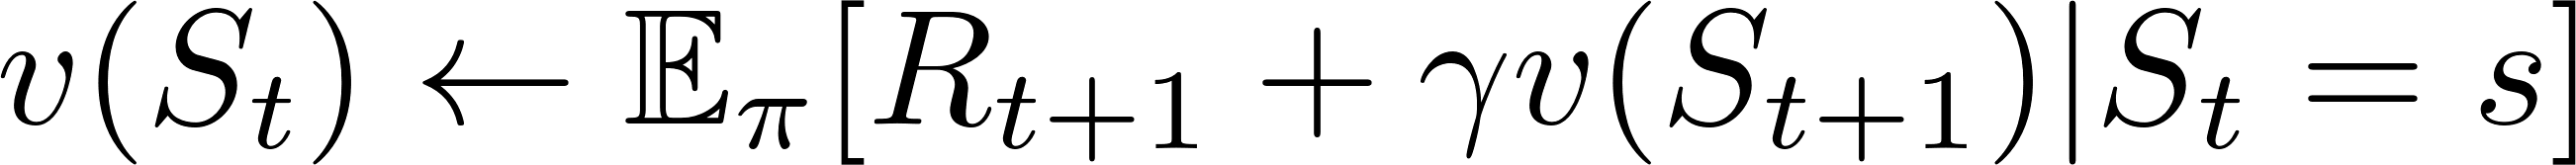
![\begin{align*}
v(S_t) \leftarrow \mathbb{E}_{\pi}[R_{t+1} + \gamma v(S_{t+1})| S_t = s]
\end{align*}](media/266317abfa.png)

Temporal difference learning
➢TD is model-free (no knowledge of MDP) and learns directly from experience
➢TD can learn from incomplete episodes, by bootstrapping
➢TD can learn during each episode
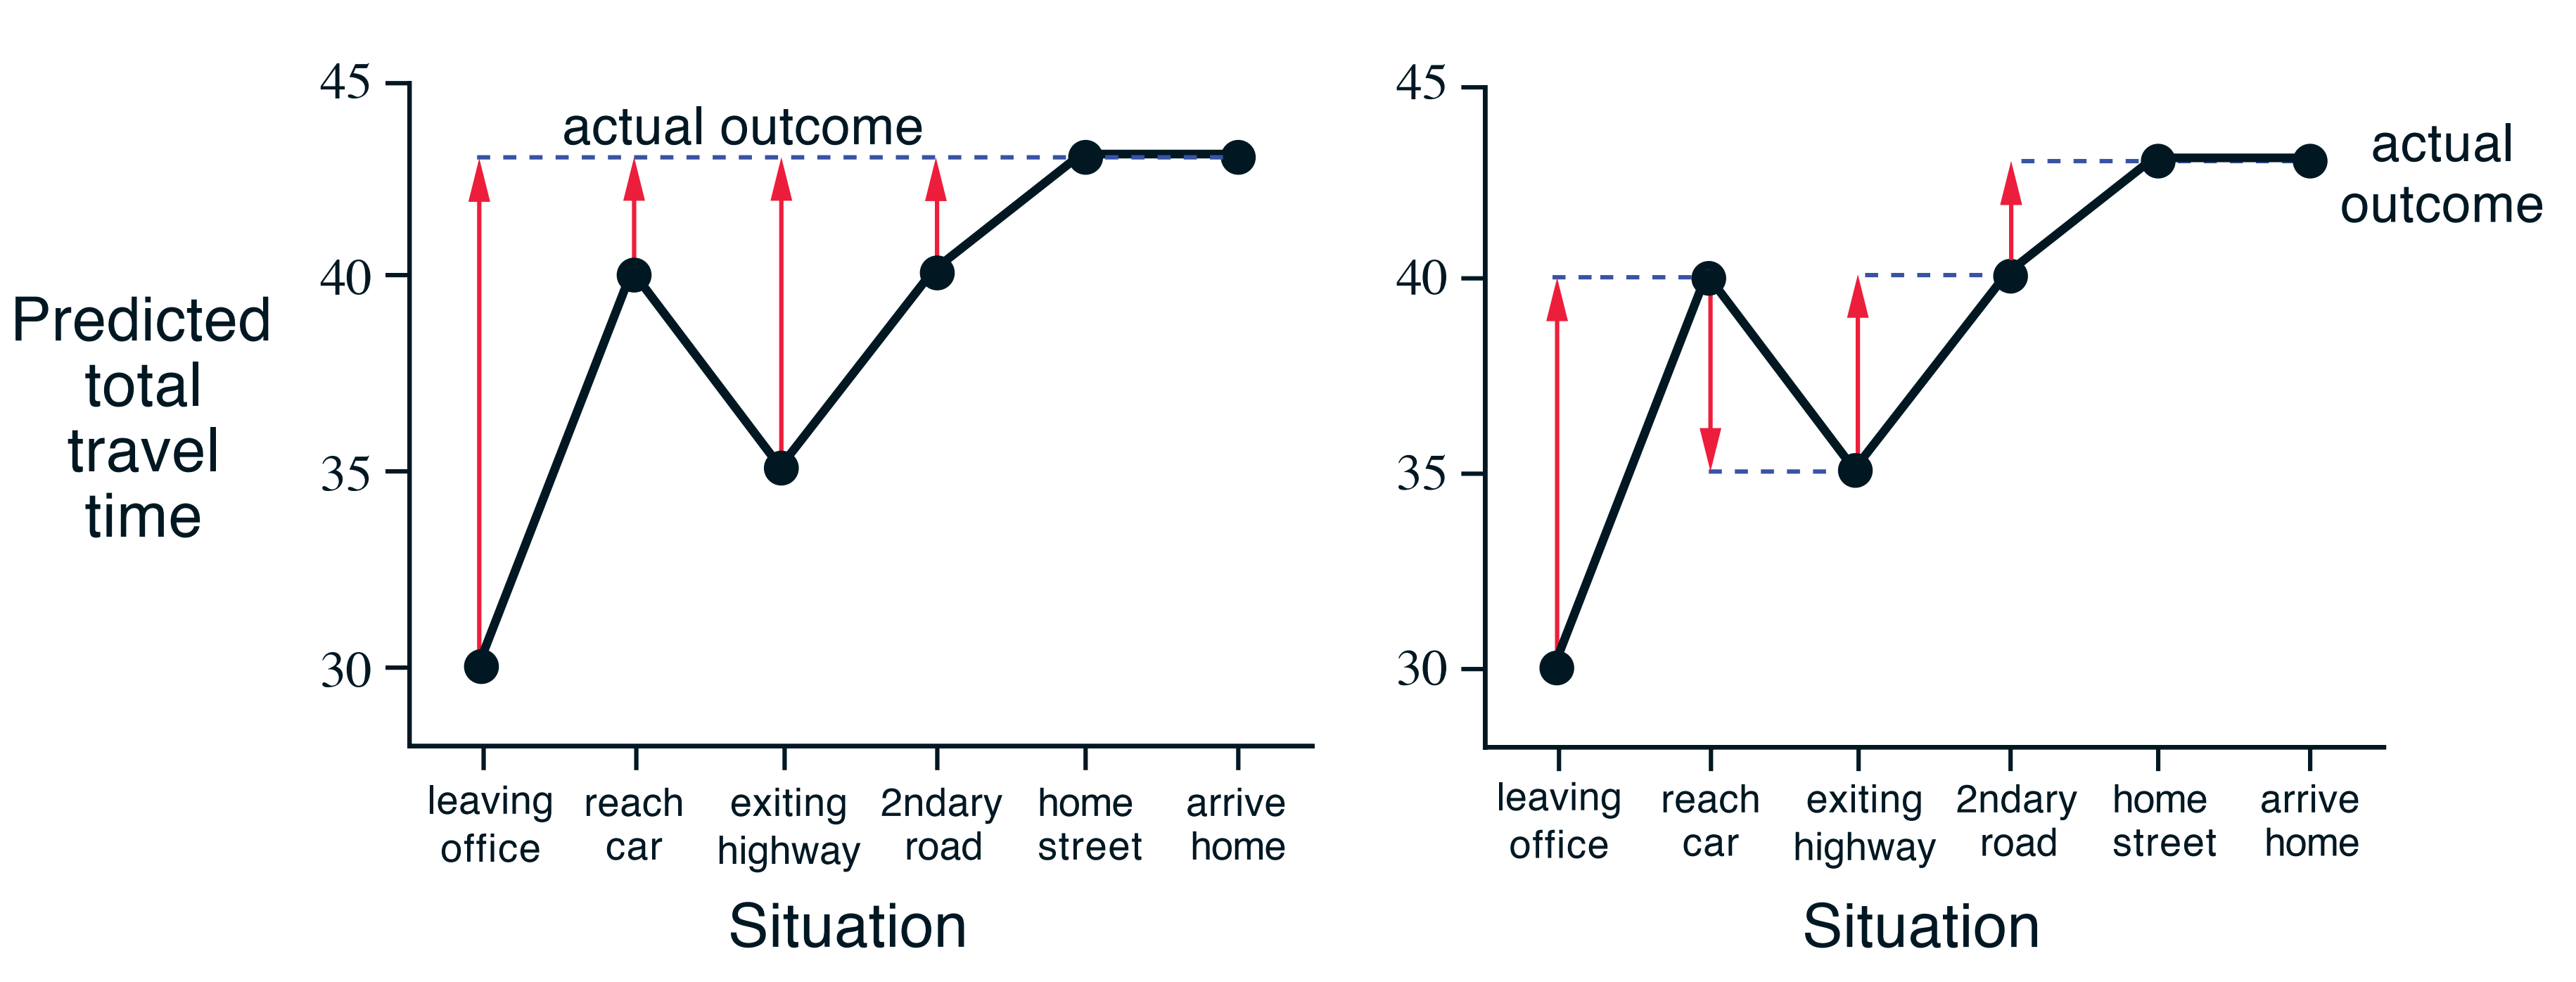
Example: Driving Home
State | Elapsed Time | Predicted Time to | Predicted Total |
Leaving office | 0 | 30 | 30 |
reach car | 5 | 35 | 40 |
Exiting highway | 20 | 15 | 35 |
2ndary road | 30 | 10 | 40 |
home street | 40 | 3 | 43 |
arrive home | 43 | 0 | 43 |
Example: Driving Home (MC vs. TD)

Changes recommended by Monte Carlo methods ()
Changes recommended by TD methods ()
Advantages and Disadvantages of MC vs. TD
➢TD can learn before knowing the final outcome
➢TD can learn online after every step
➢MC must wait until end of episode before return is known (offline)
➢TD can learn without the final outcome
➢TD can learn from incomplete sequences
➢MC can only learn from complete sequences
➢TD works in continuing (non-terminating) environments
➢MC only works for episodic (terminating) environments
➢TD is independent of the temporal span of the prediction
➢TD can learn from single transitions
➢MC must store all predictions (or states) to update at the end of an episode
➢TD needs reasonable value estimates
Bias/Variance Trade-Off
MC return

Unbiased estimate of
Why?
TD target
Biased estimate of
Why?
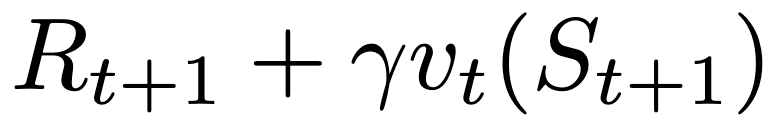
Higher Variance: Return depends on many random actions, transitions, rewards.
Lower Variance: TD target depends on one random action, transition, reward.
Variance:
Bias:
Variance:
Bias:
Bias/Variance Trade-Off
➢In some cases, TD can have irreducible bias
➢The world may be partially observable
➢MC would implicitly account for all the latent variables
➢The function to approximate the values may fit poorly
➢In the tabular case, both MC and TD will converge:
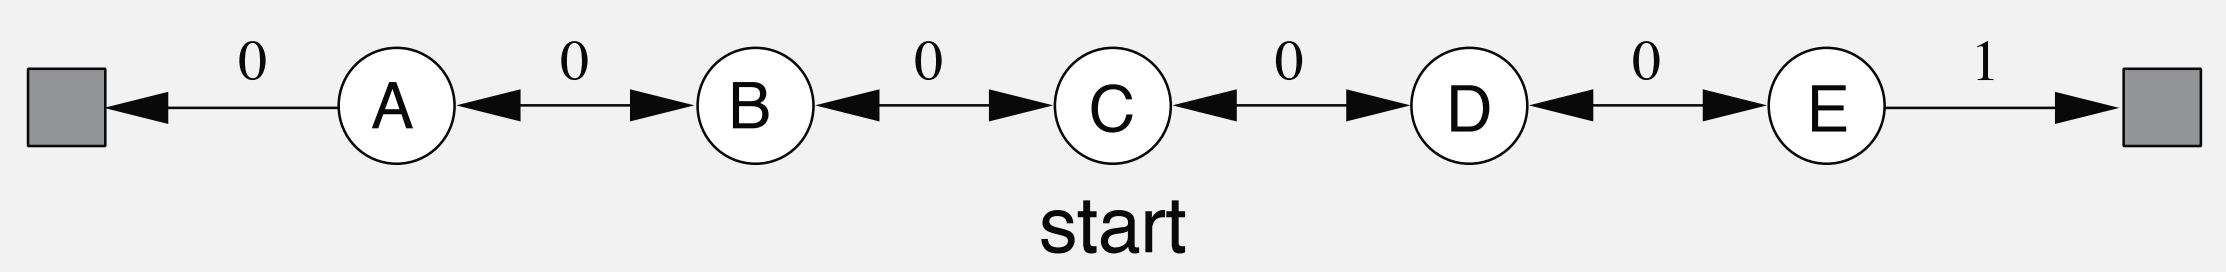
Example: Random Walk

➢Uniform random transitions (50% left, 50% right)
➢Initial values are , for all states
Example: Random Walk
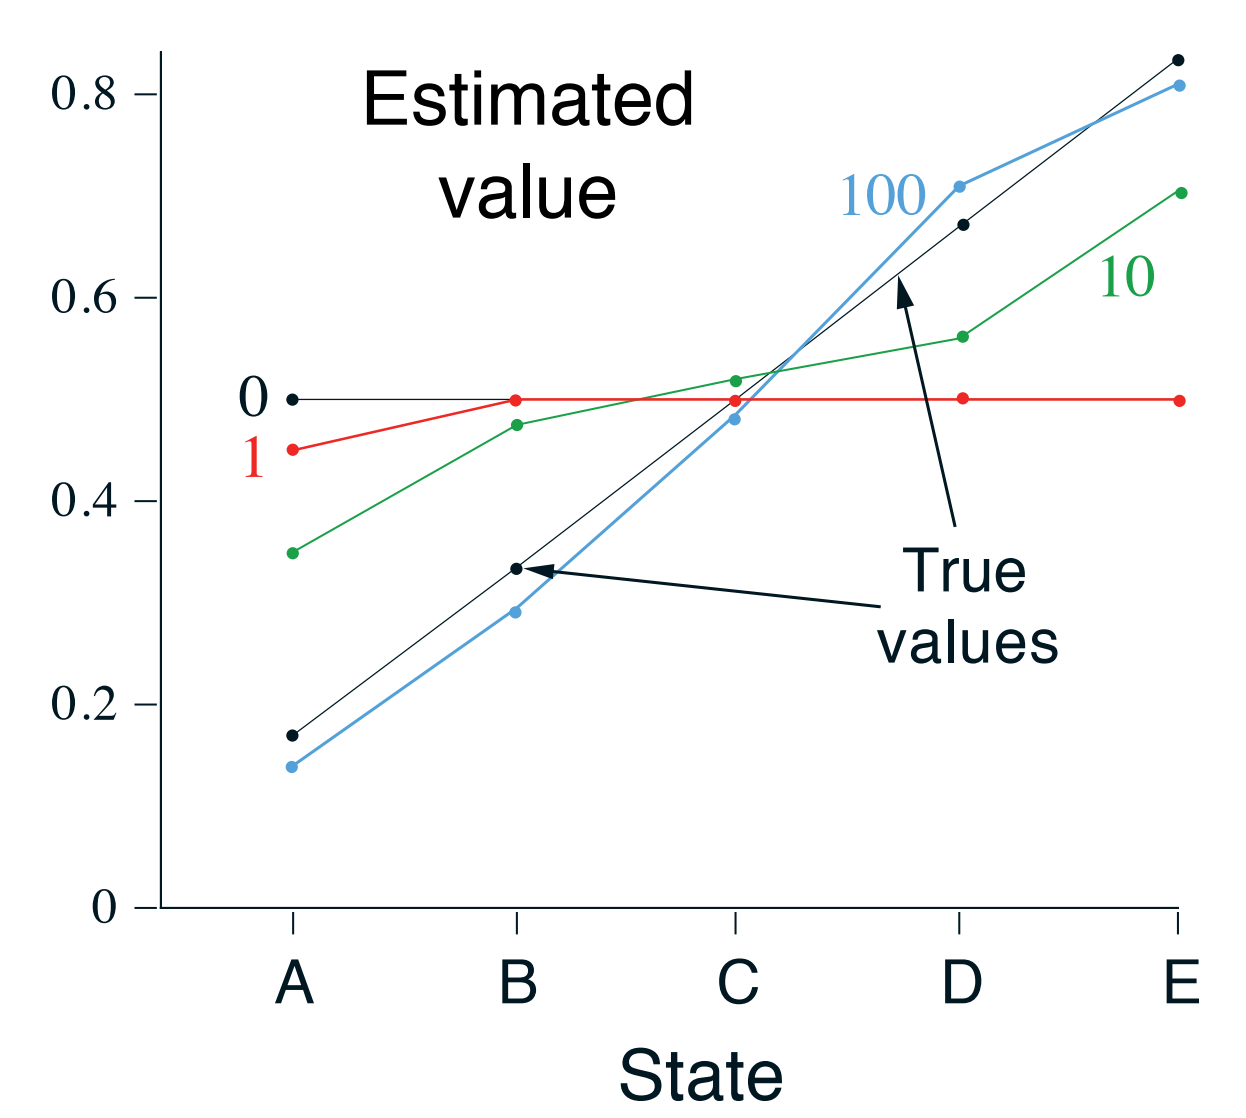

True values
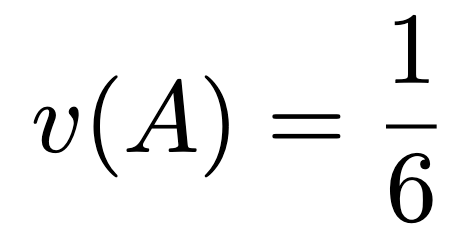


Example: Random Walk (MC vs. TD)
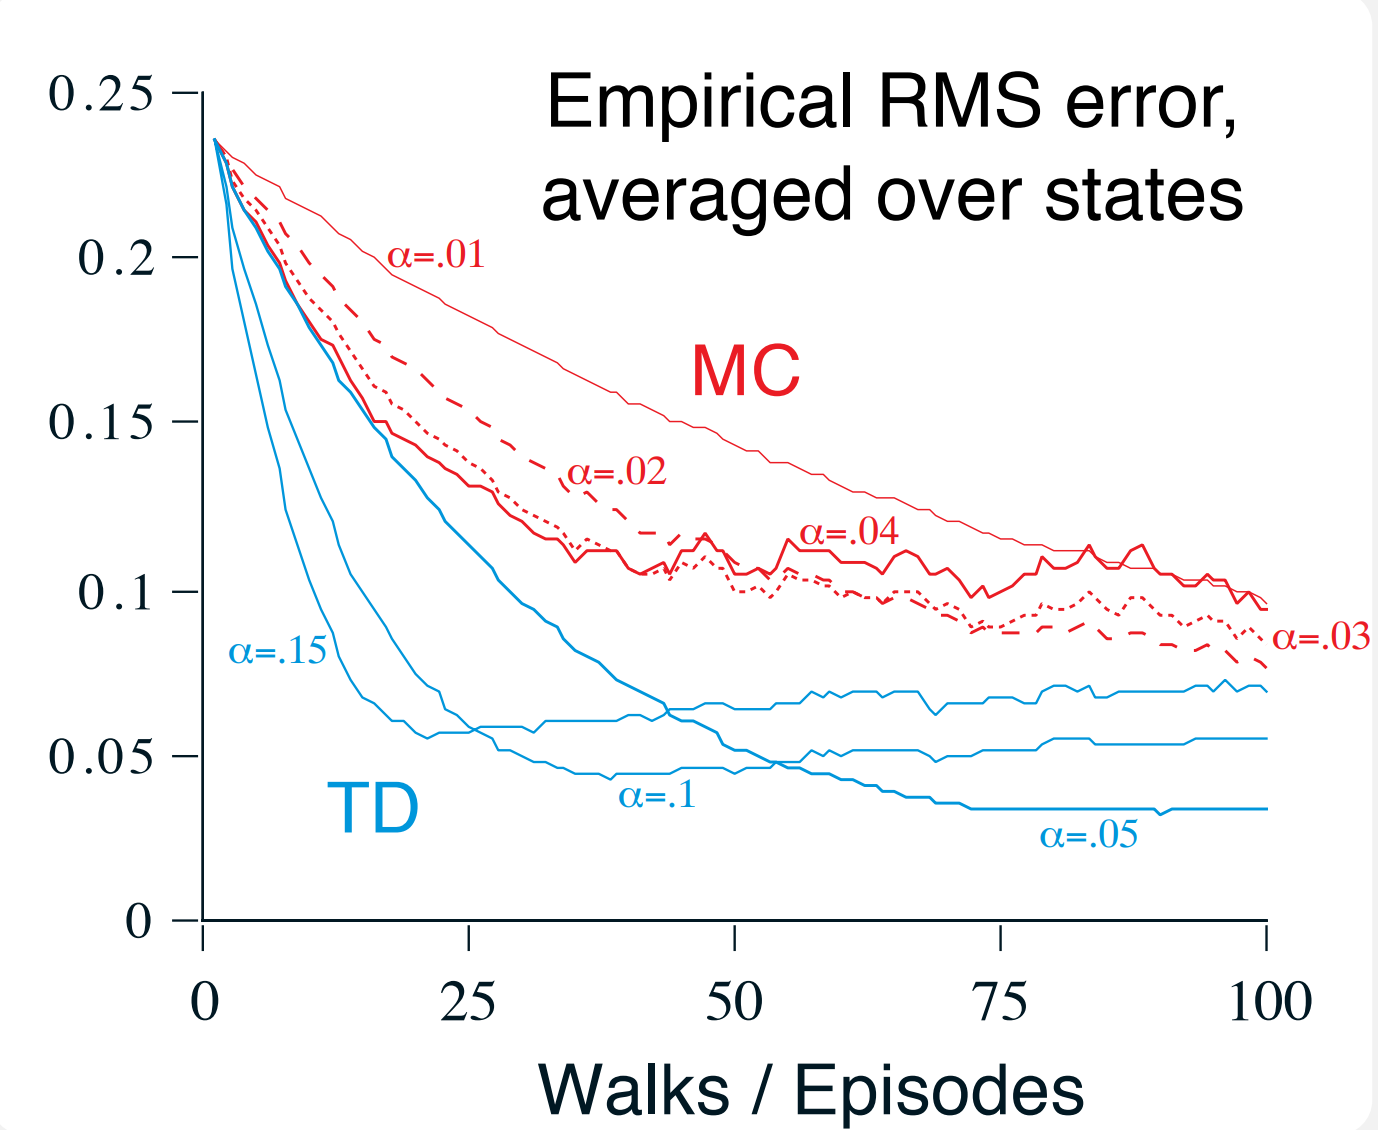
Which method performed
better on this task?
Batch MC and TD
➢Tabular MC and TD converge: as experience and
But what about finite experience?
Repeatedly sample each episode and apply MC or TD(0)
Sampling from an
empirical model
Consider a fixed batch of experiences:
Episode 1:
Episode k:
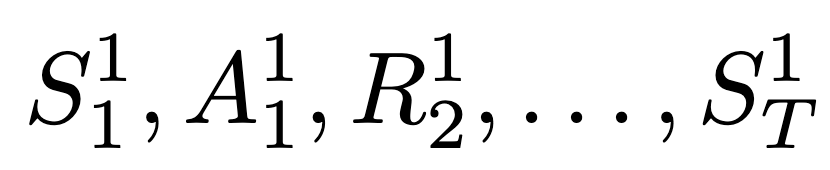
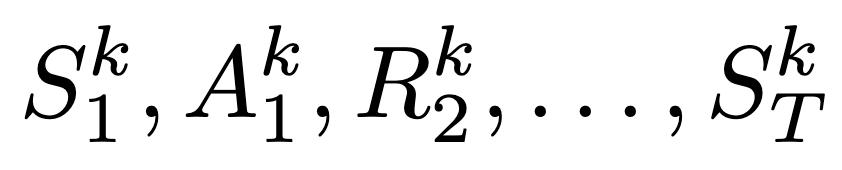
Example: Batch Learning in Two States
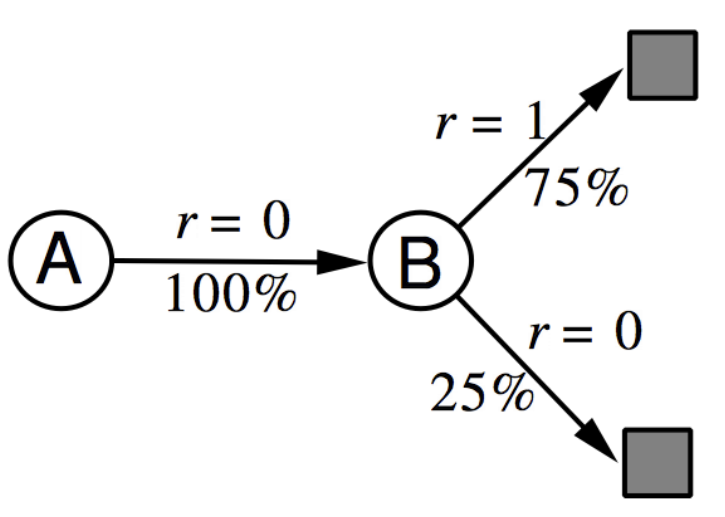
➢Two states A, B
➢No discounting
➢8 episodes
What is v(A), v(B)?
1)A, 0, B, 0
2)B, 1
3)B, 1
4)B, 1
5)B, 1
6)B, 1
7)B, 1
8)B, 0
Batch TD(0)
Batch MC
Differences in batch solutions
MC converges to the best mean-squared fit for the observed returns
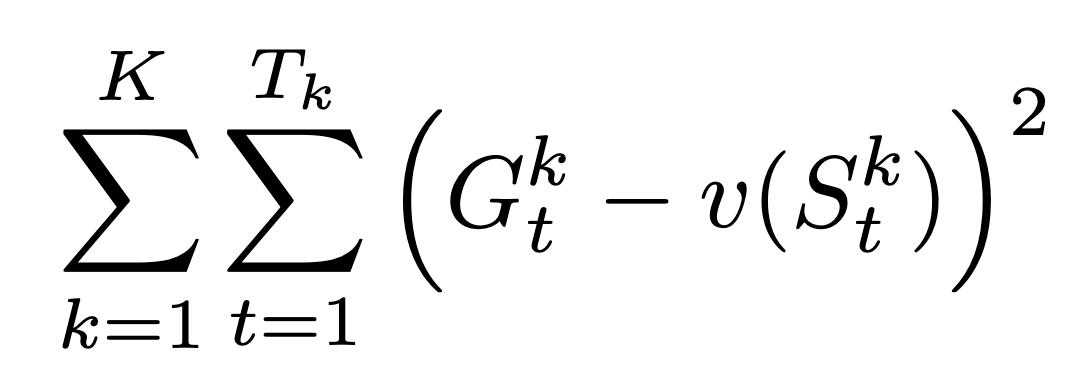
TD converges to the solution of the max likelihood Markov model, given the data
➢Solution to the empirical MDP that best fits the data
➢In the AB example:
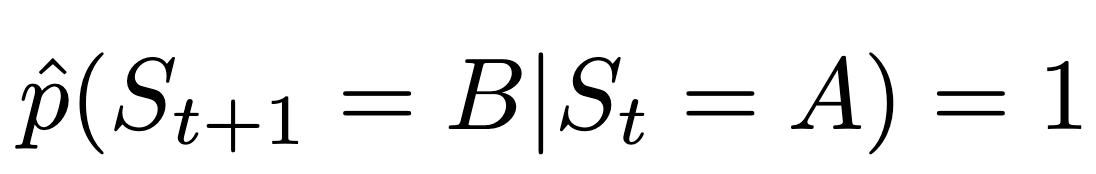
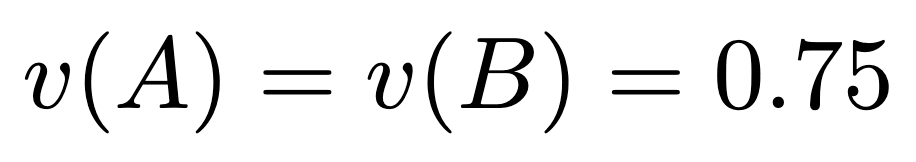
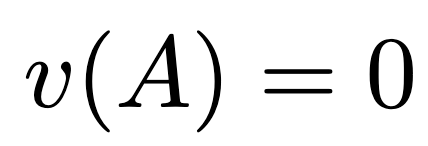

Advantages and Disadvantages of MC vs. TD
➢TD exploits the Markov property
➢Can help in fully-observable environments
➢MC does not exploit the Markov property
➢Can help in partially-observable environments
➢With finite data, or with function approximation, the solutions may differ
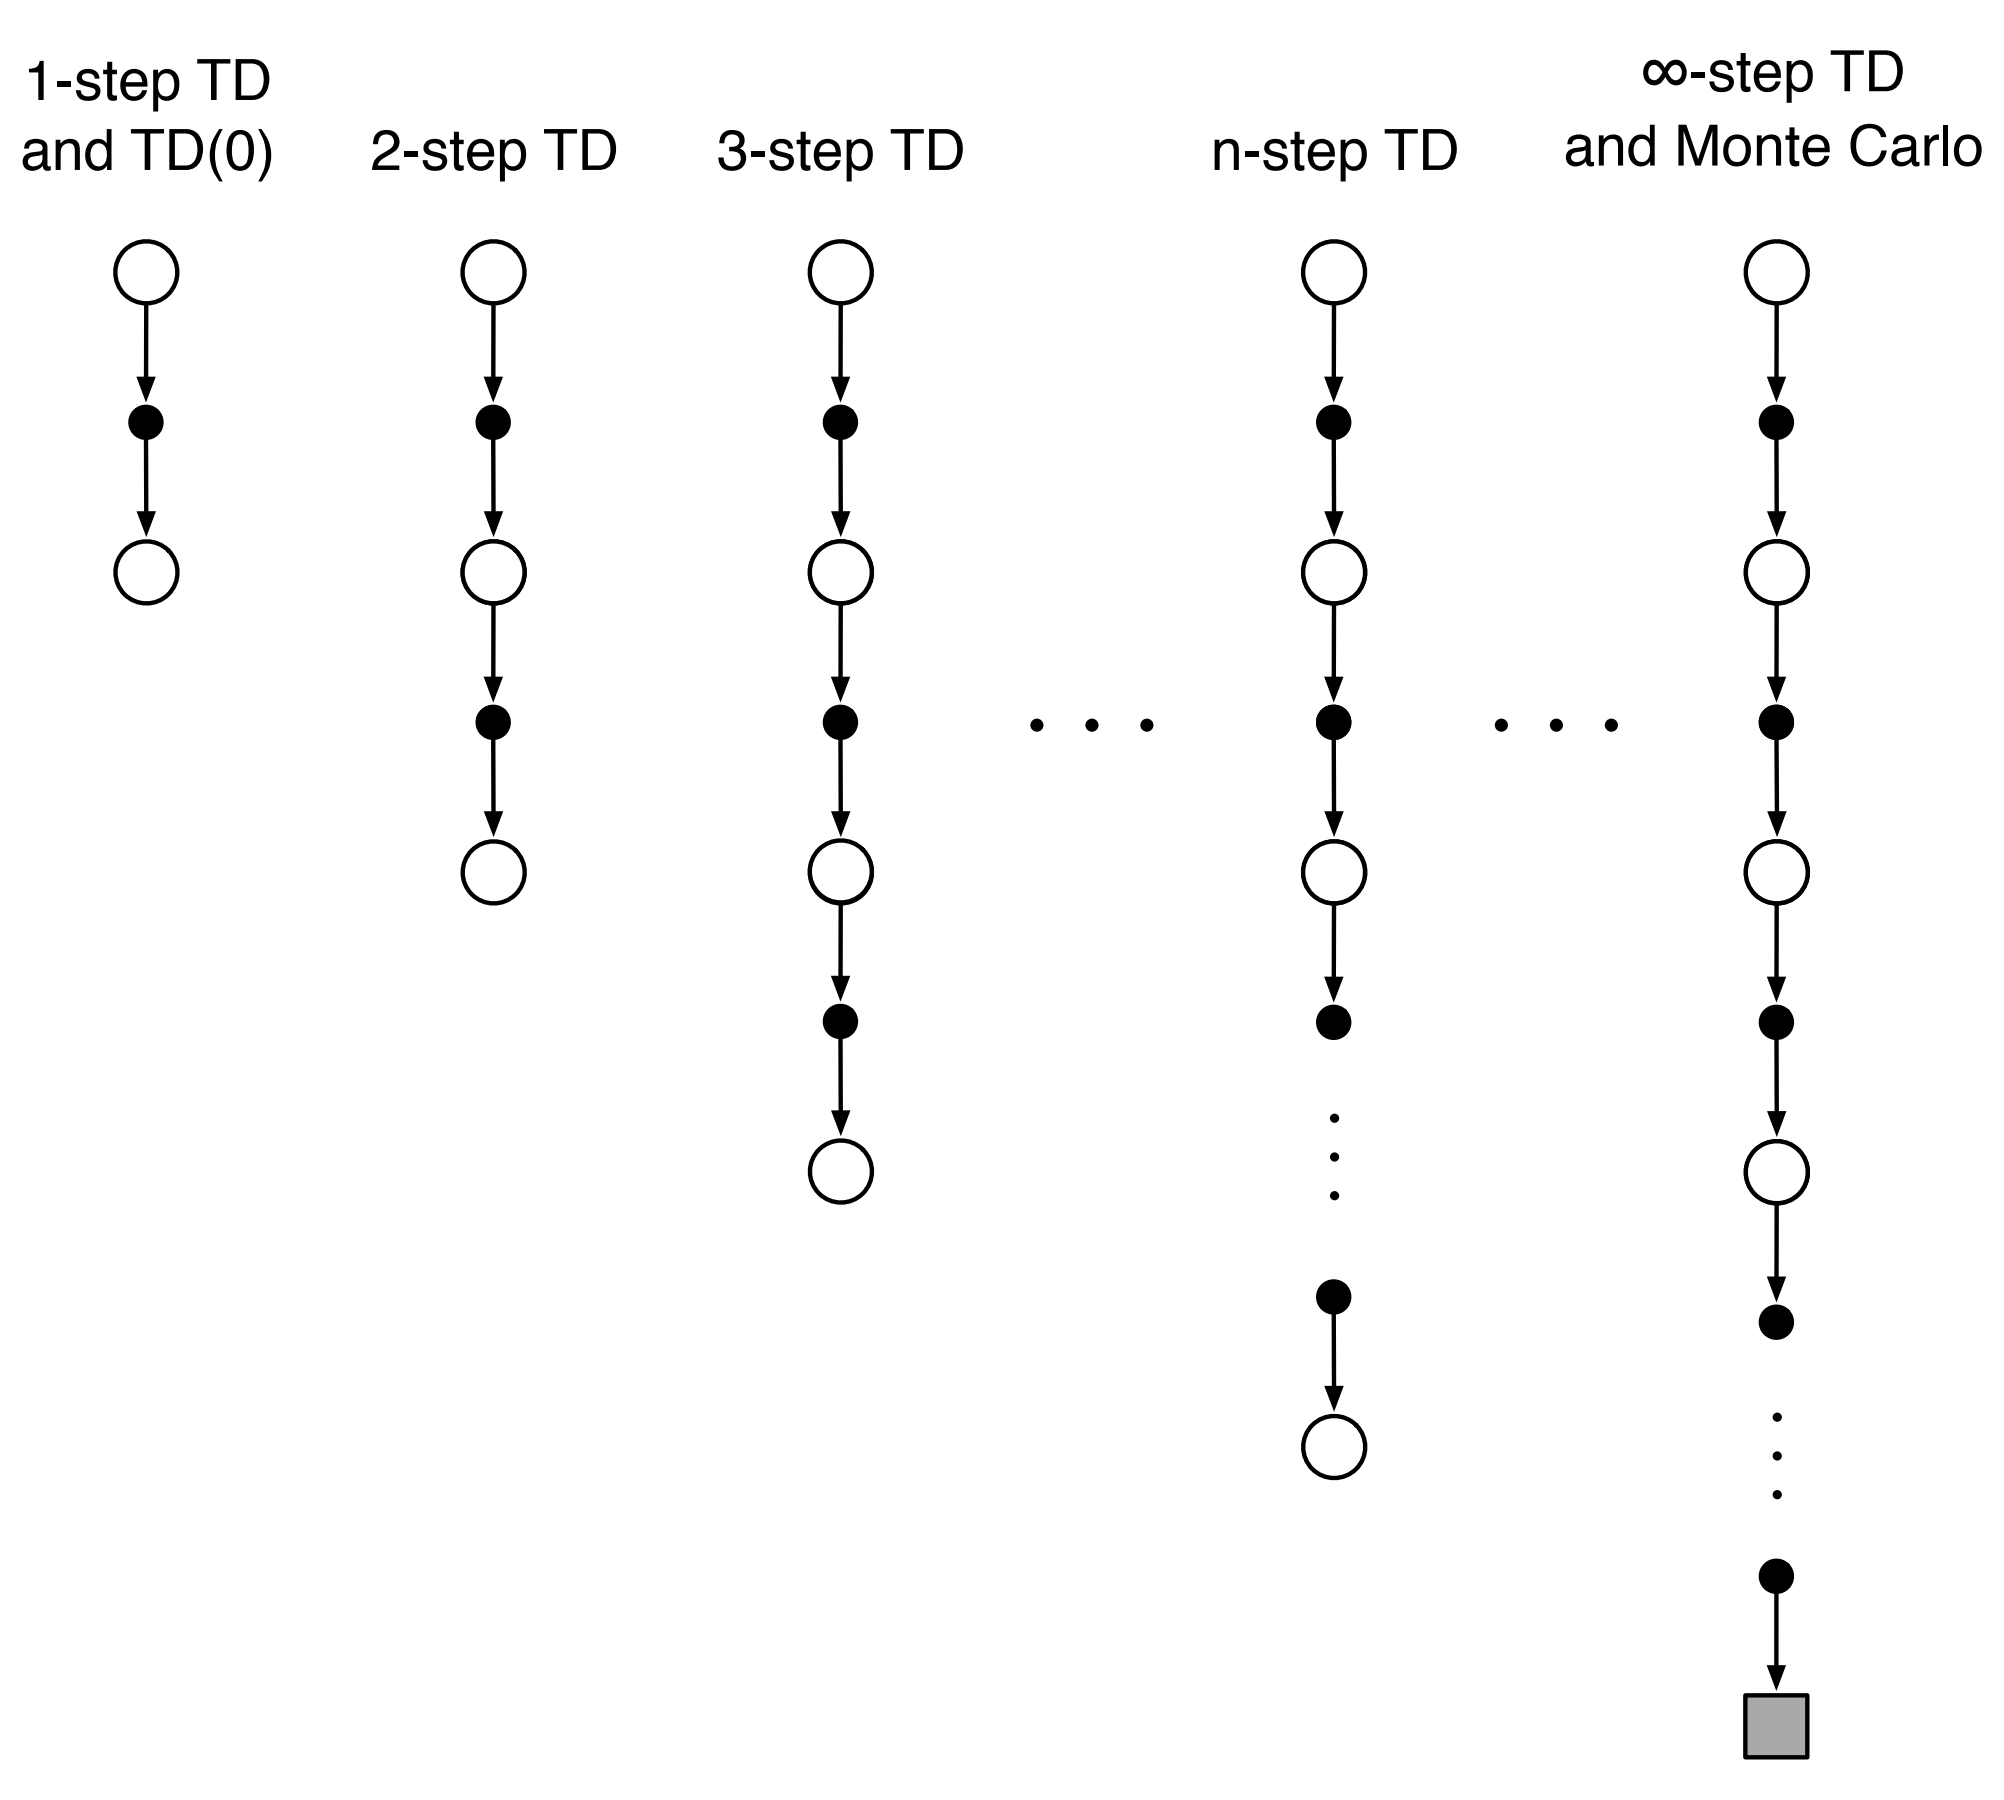
Between MC and TD: Multi-Step TD
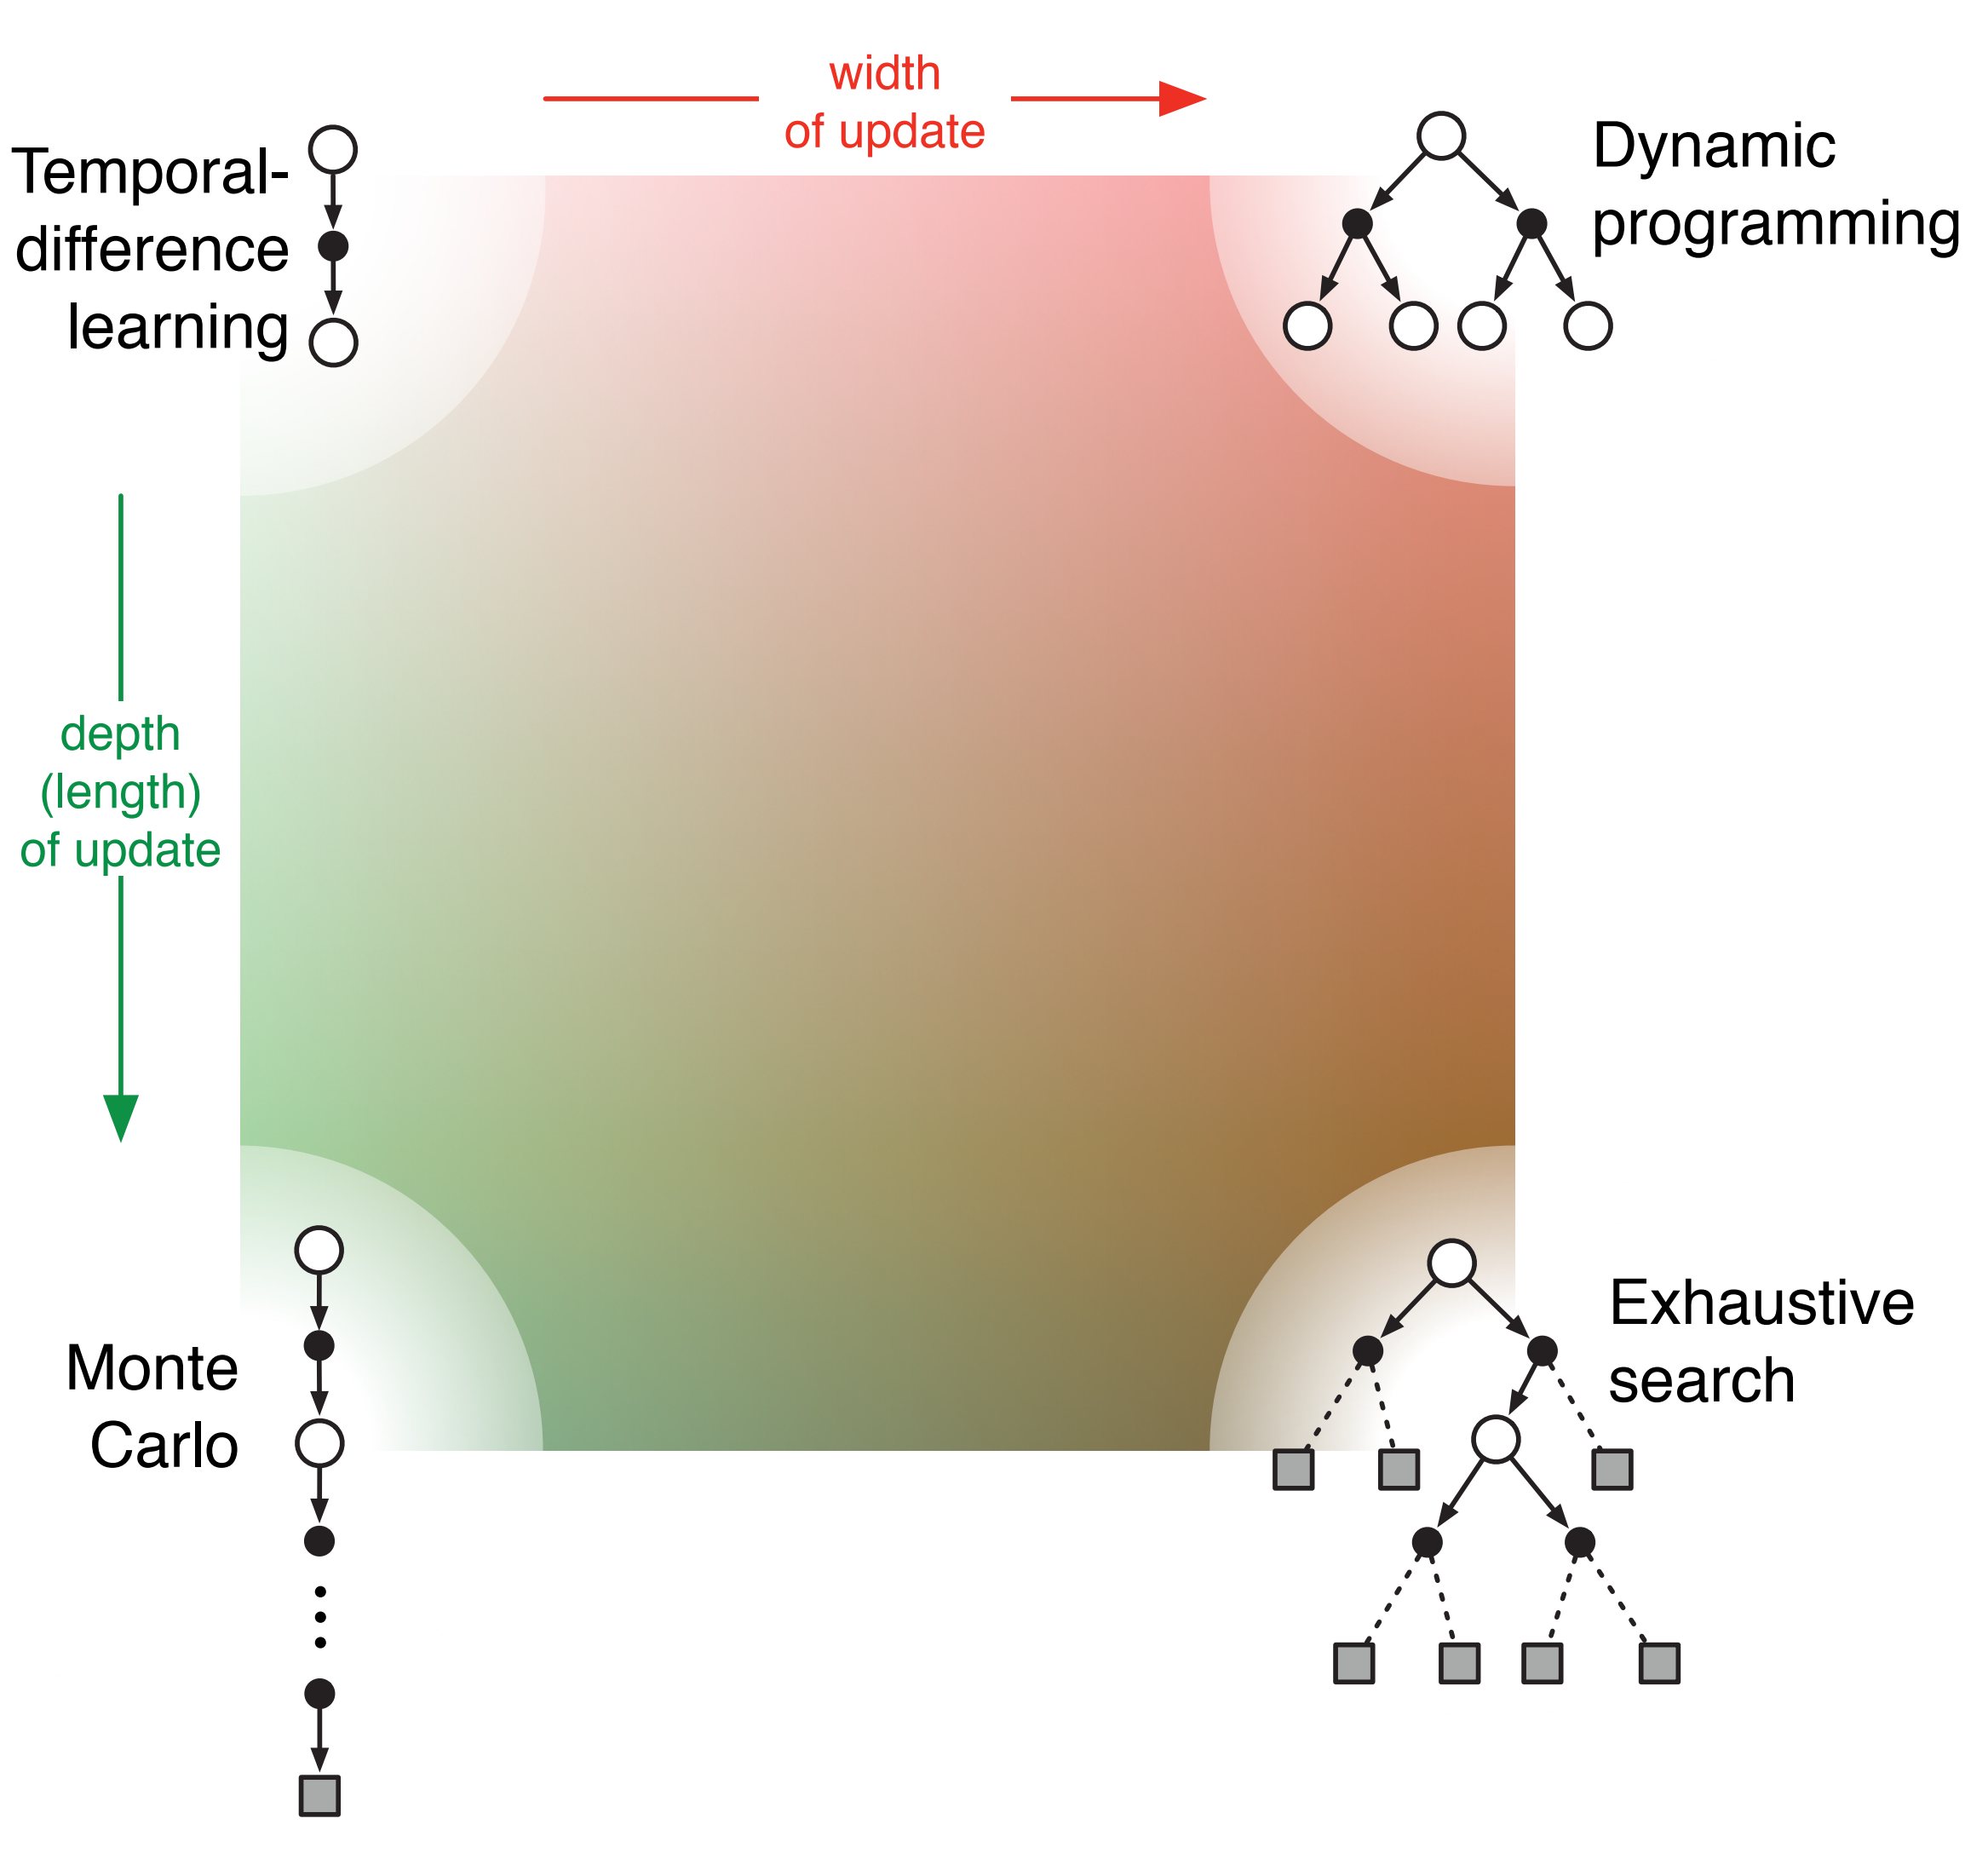
Unified View of
Reinforcement Learning
Multi-Step Updates
➢TD uses value estimates, which might be inaccurate.
➢In addition, information can propagate back quite slowly.
➢In MC, information propagates faster, but the updates are noisier.
➢We can go somewhere in between TD and MC

Multi-Step Prediction
Let the TD target look
steps into the future

Multi-Step Prediction
Let the TD target look
steps into the future
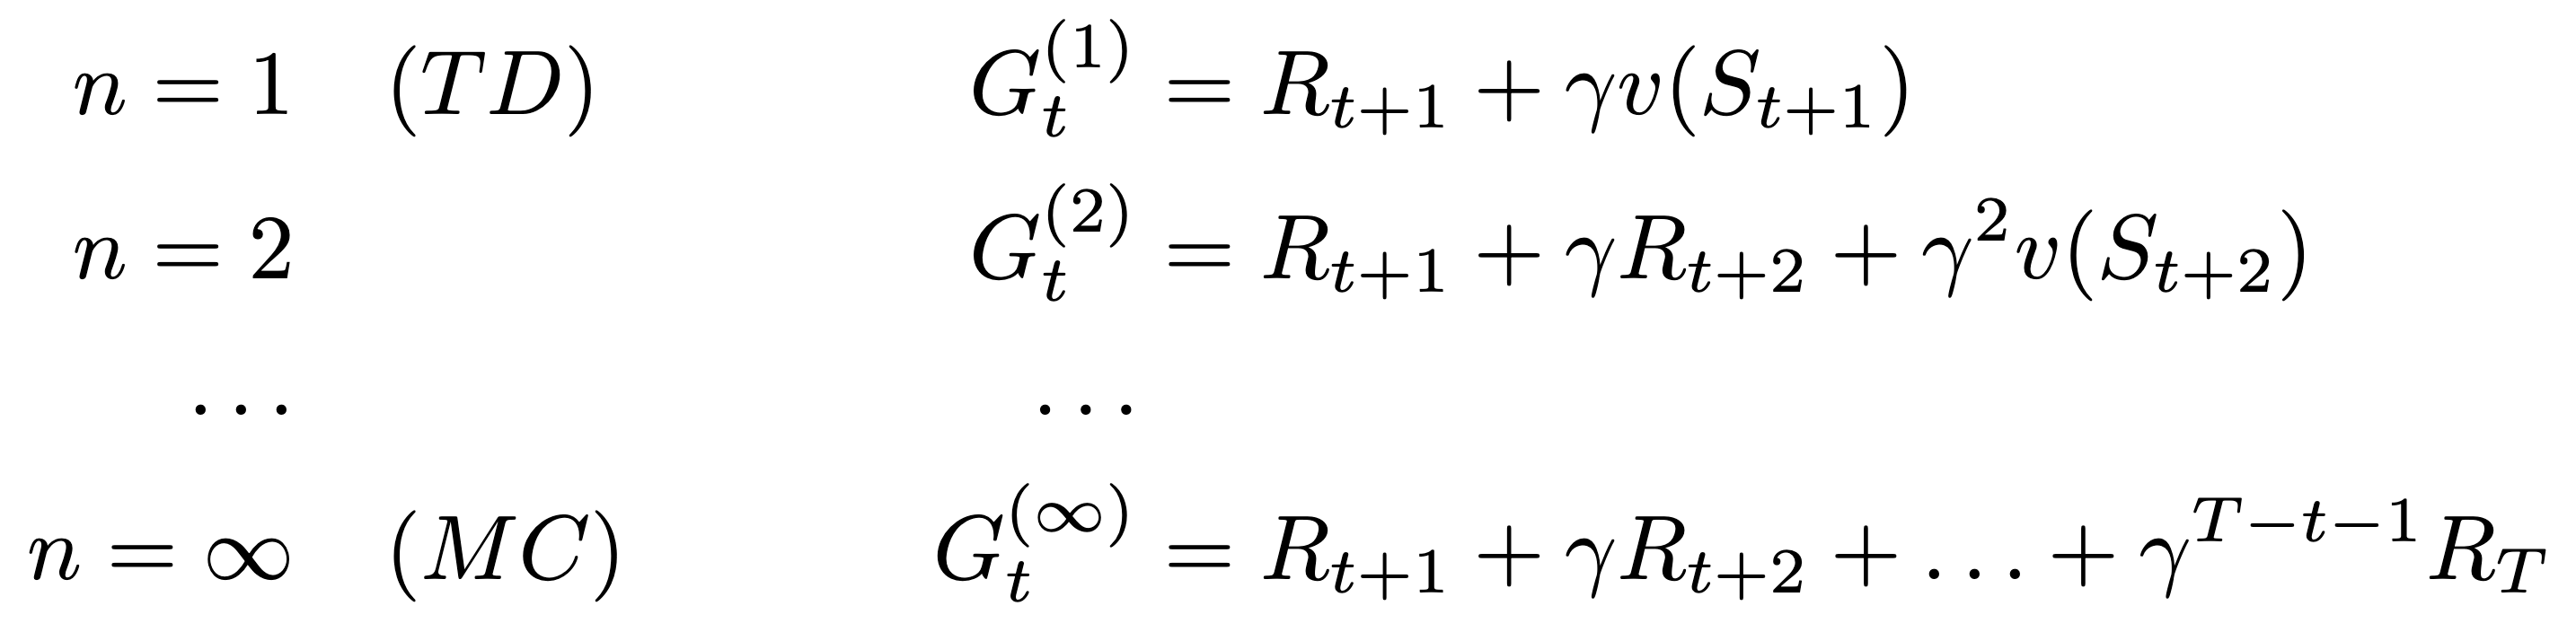


Multi-Step Prediction
Let the TD target look
steps into the future


-step returns
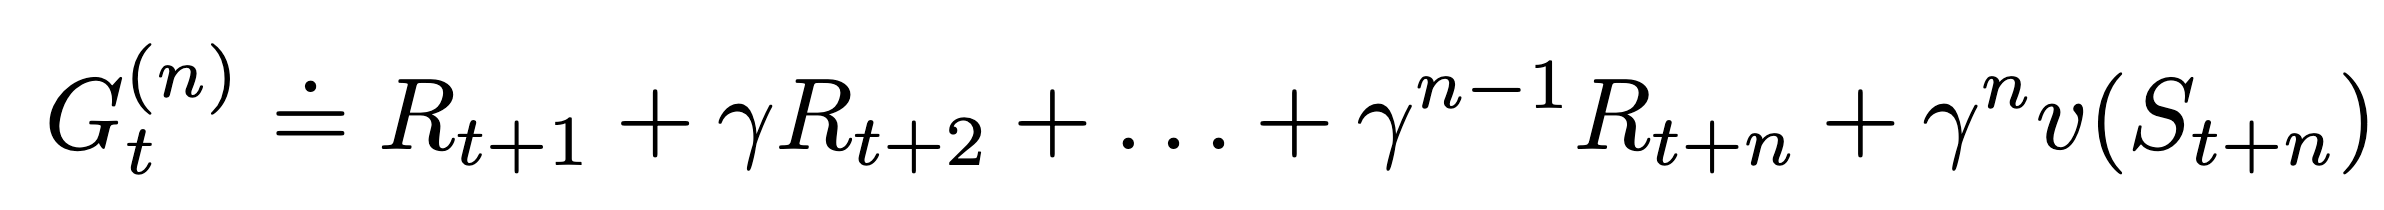


n-step TD
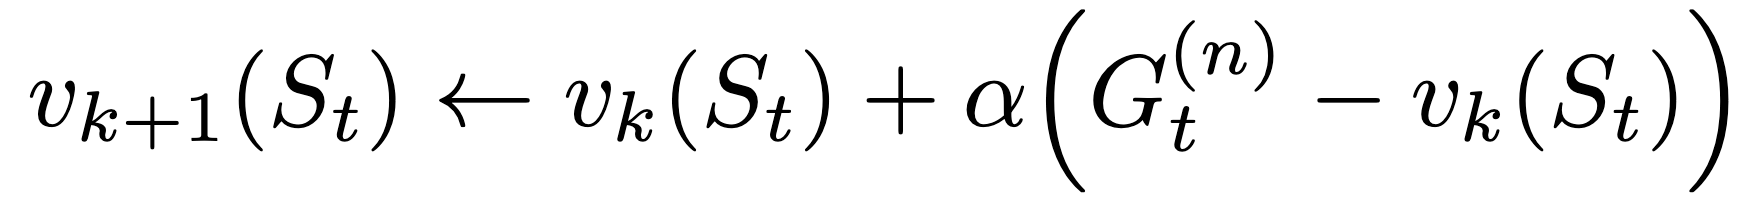
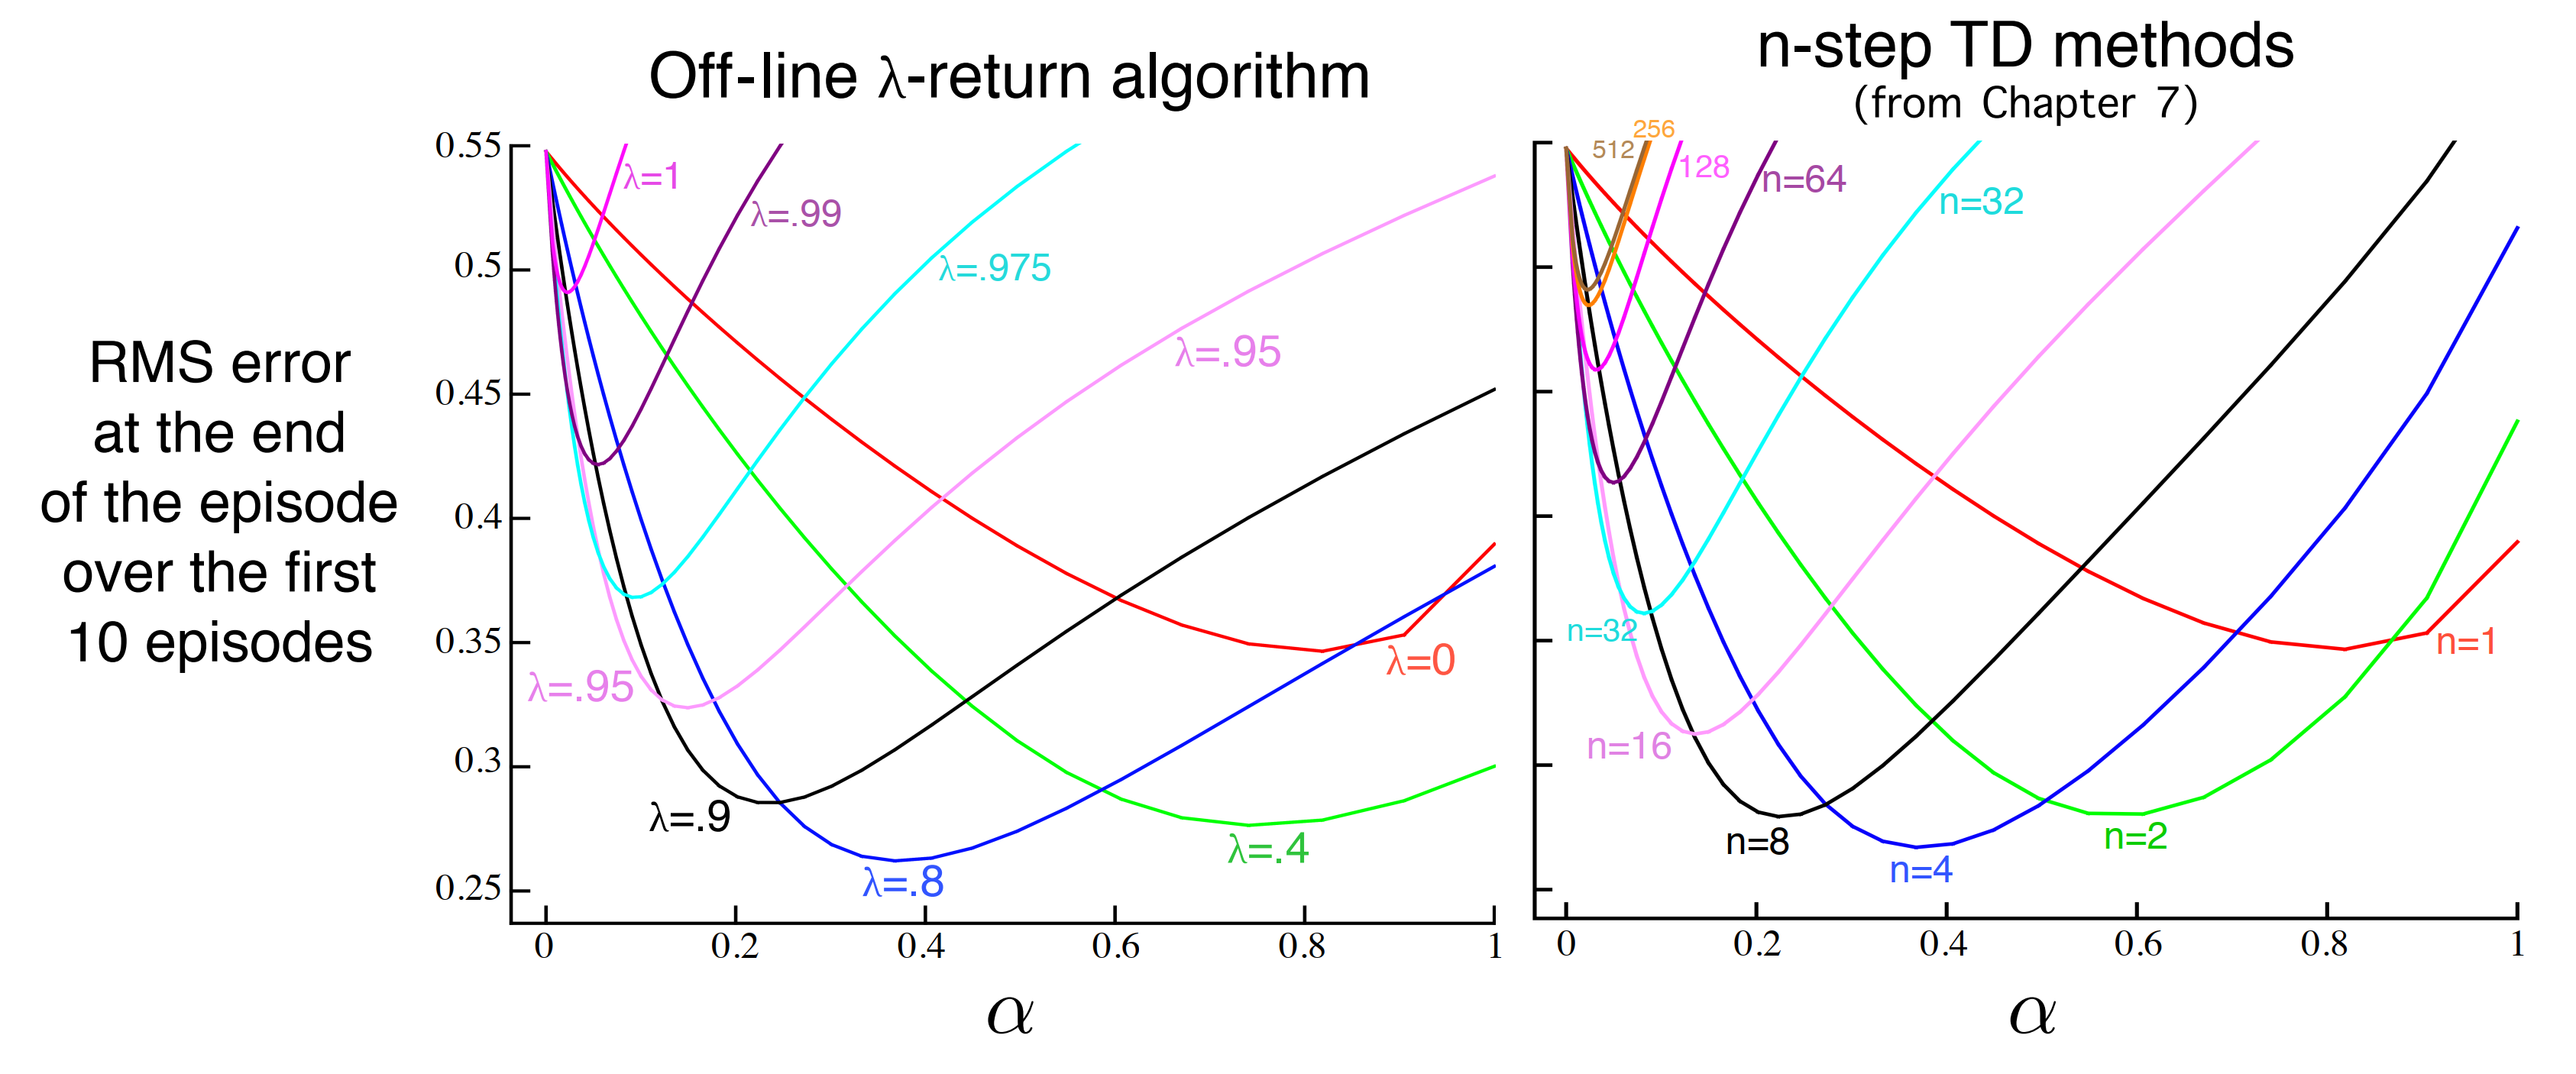
Example: Large Random Walk
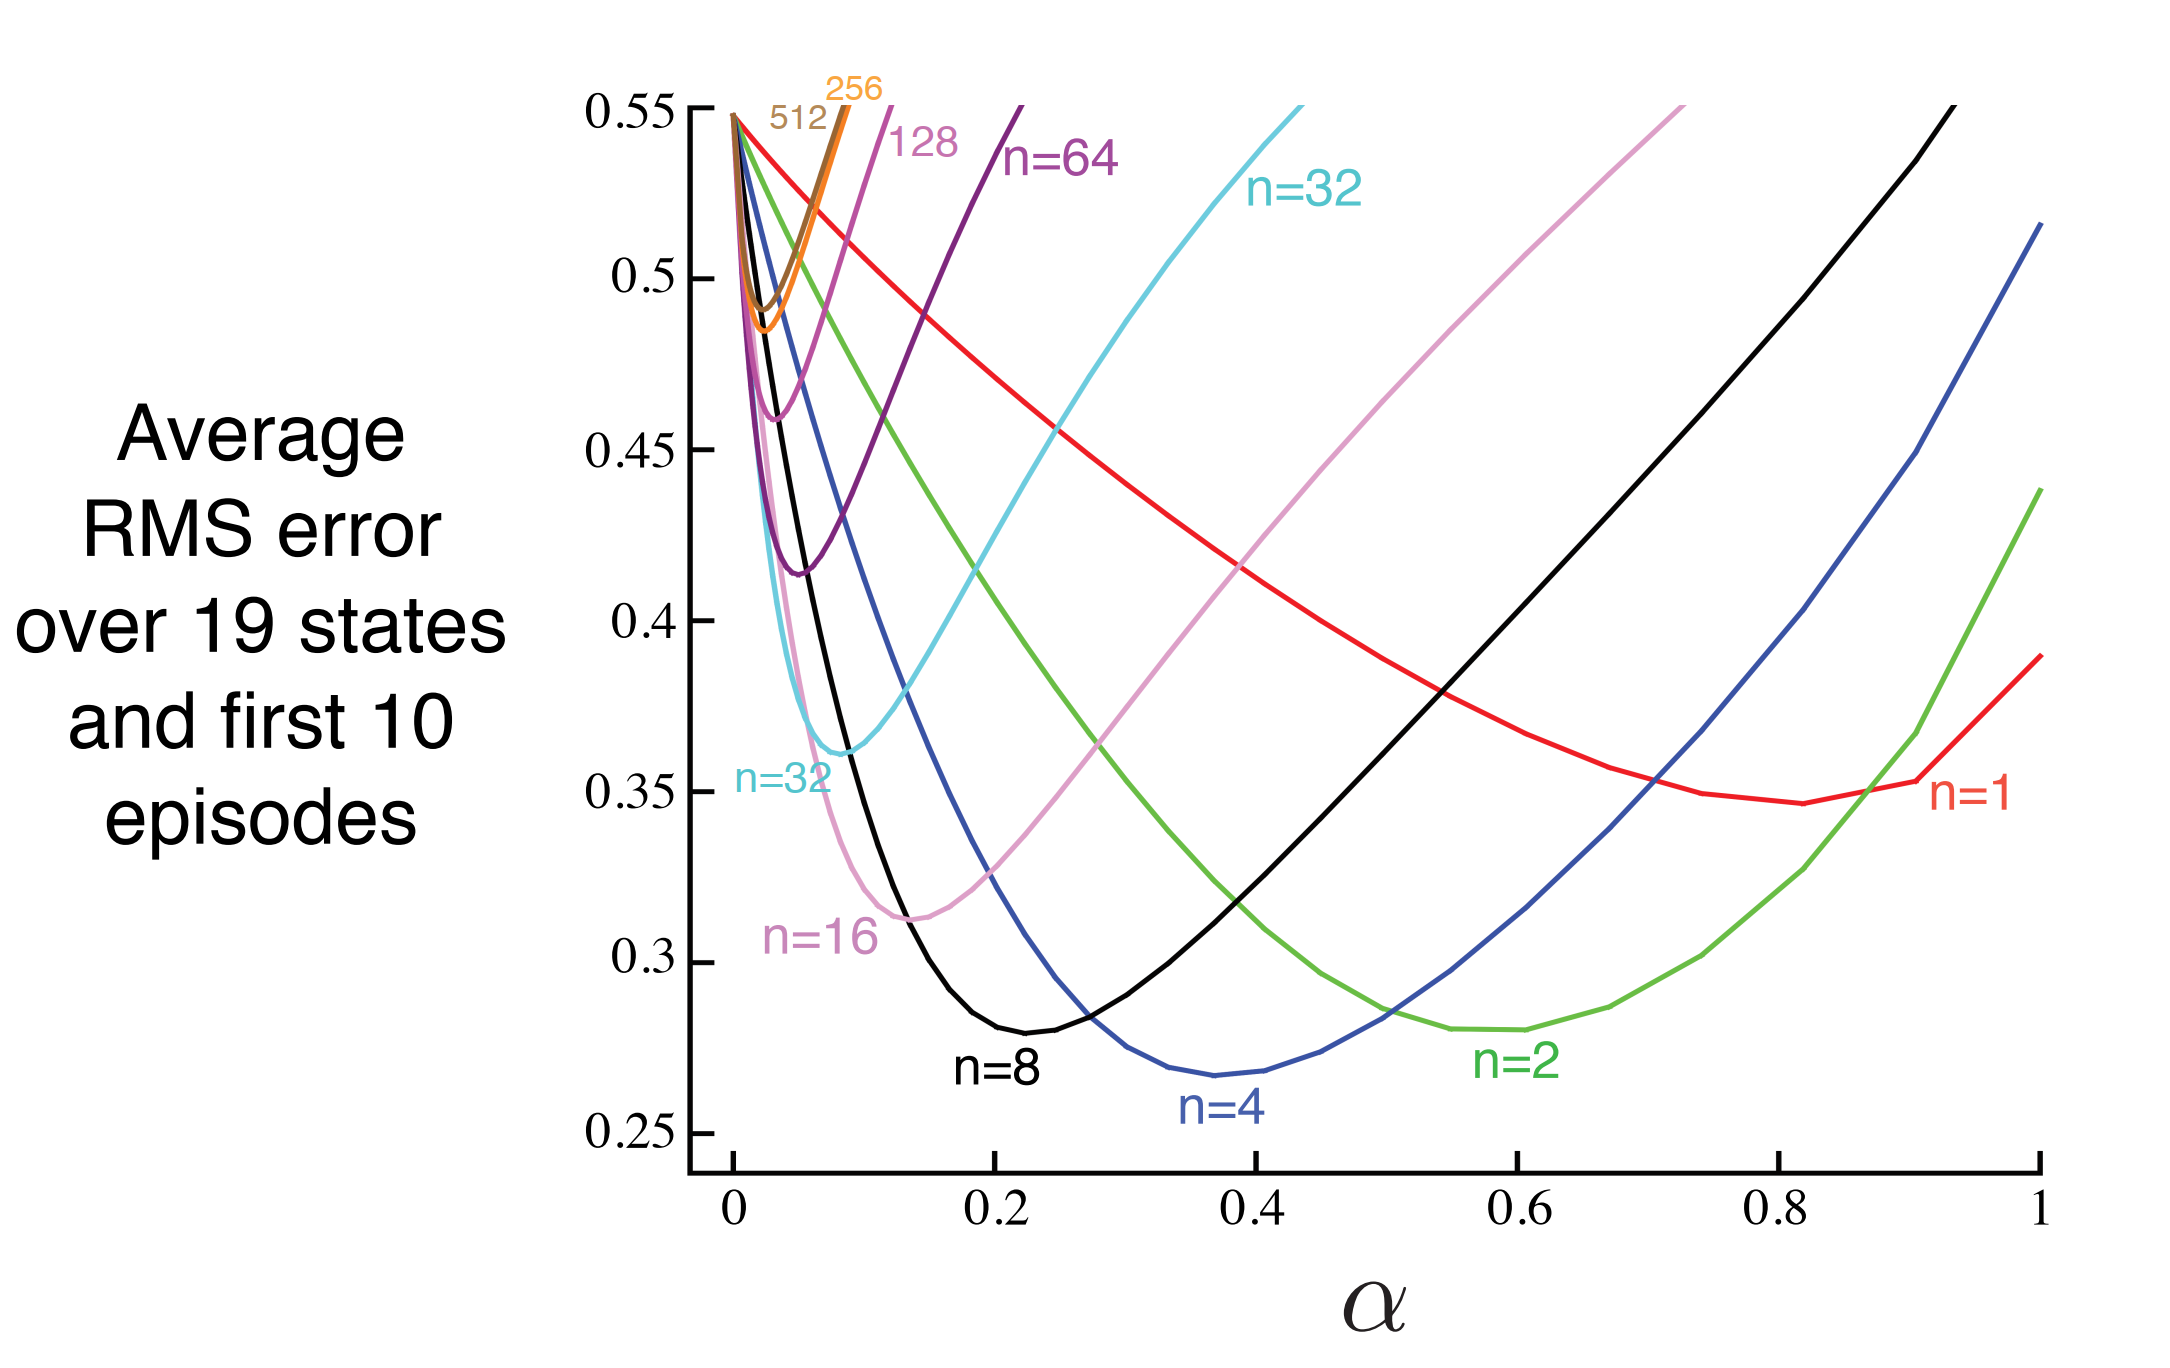
Imagine a LARGER random walk.
19 states instead of only 5

Average RMS error
over 19 states and first
10 episodes
Performance of the -step TD method as a function of

Mixed Multi-Step Returns


n-step TD


Mixed Multi-Step Returns


Which should we choose?
Why not select all n-step returns?
Let’s consider a weighted sum with .
n-step TD


Mixed Multi-Step Returns


Which should we choose?
Why not select all n-step returns?
Let’s consider a weighted sum with .
n-step TD


Mixed Multi-Step Returns


Note that:
To normalize this sum, multiply it by
Let’s use these weights to
average the n-step returns!
n-step TD


Mixed Multi-Step Returns


Note that:
To normalize this sum, multiply it by
Let’s use these weights to
average the n-step returns!
Mixed Multi-Step Returns
update equation
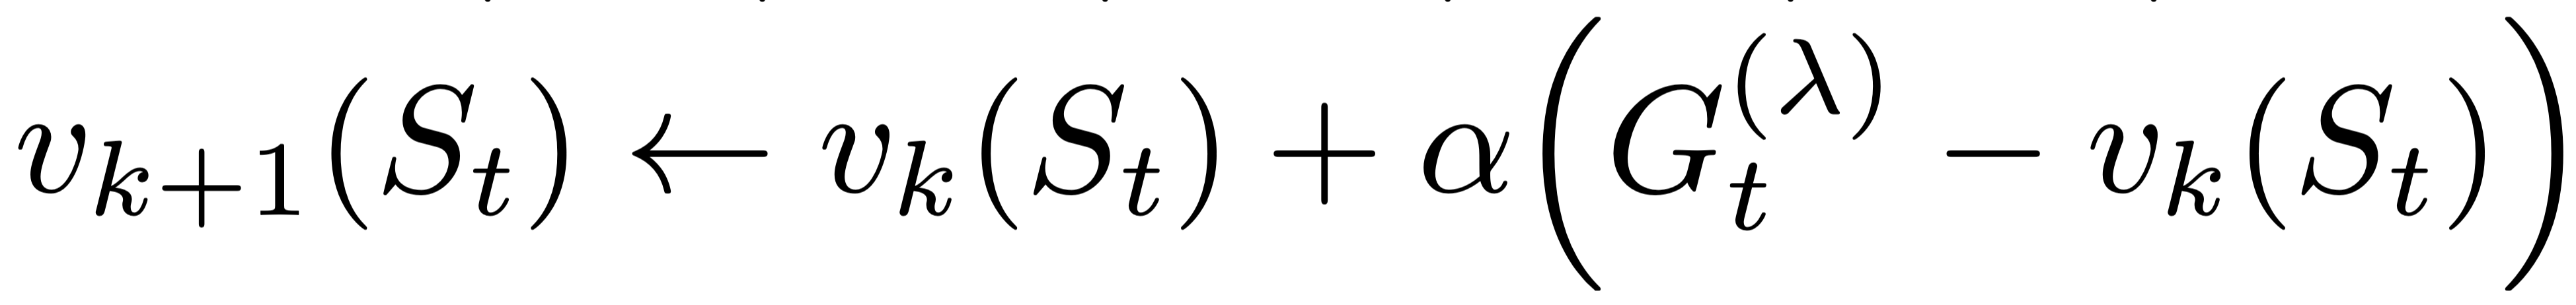
n-step TD

How to compute TD() online?
Eligibility Traces
Mixed Multi-Step Returns
update equation

Try to derive
it at home.

TD(0)

MC
How to obtain TD(0) and MC from the equation above?
Eligibility Traces
Mixed Multi-Step Returns
update equation
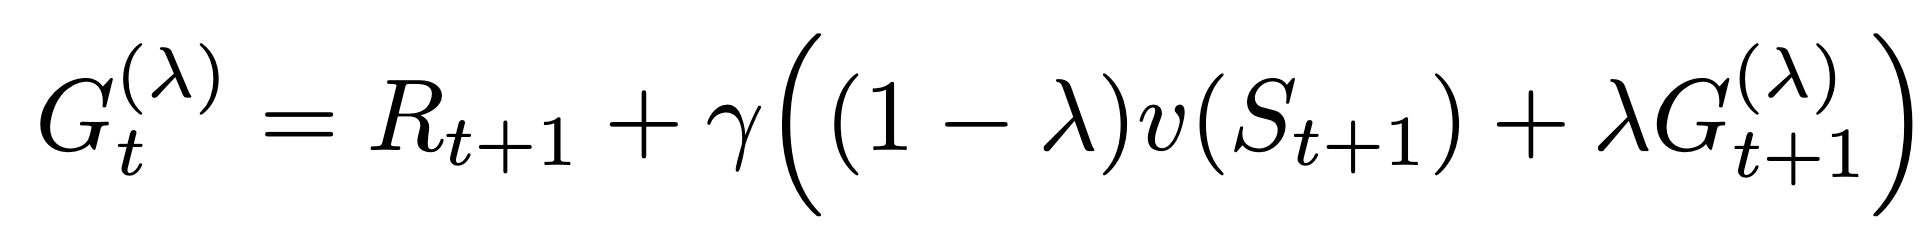

Try to derive
it at home.
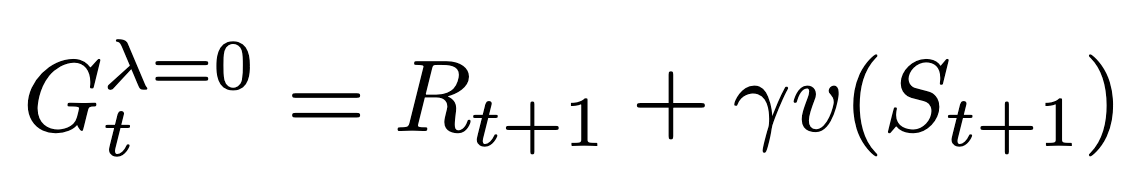
Total change of
over an episode.
Eligibility Traces
Mixed Multi-Step Returns
update equation


Try to derive
it at home.
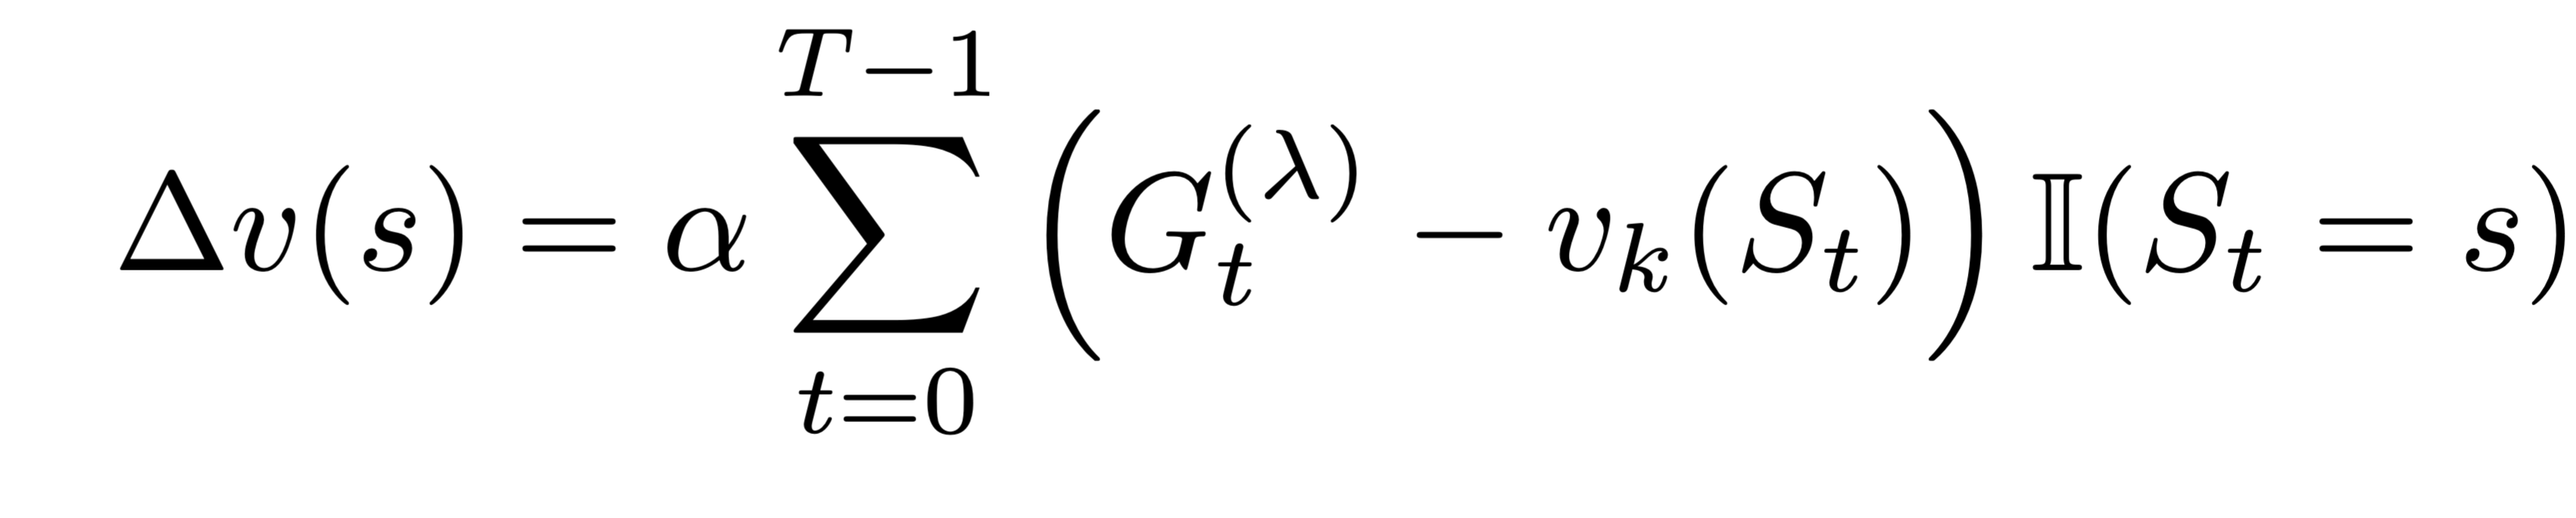
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
Total change of
over an episode.
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
Eligibility Traces
Mixed Multi-Step Returns
update equation


Try to derive
it at home.
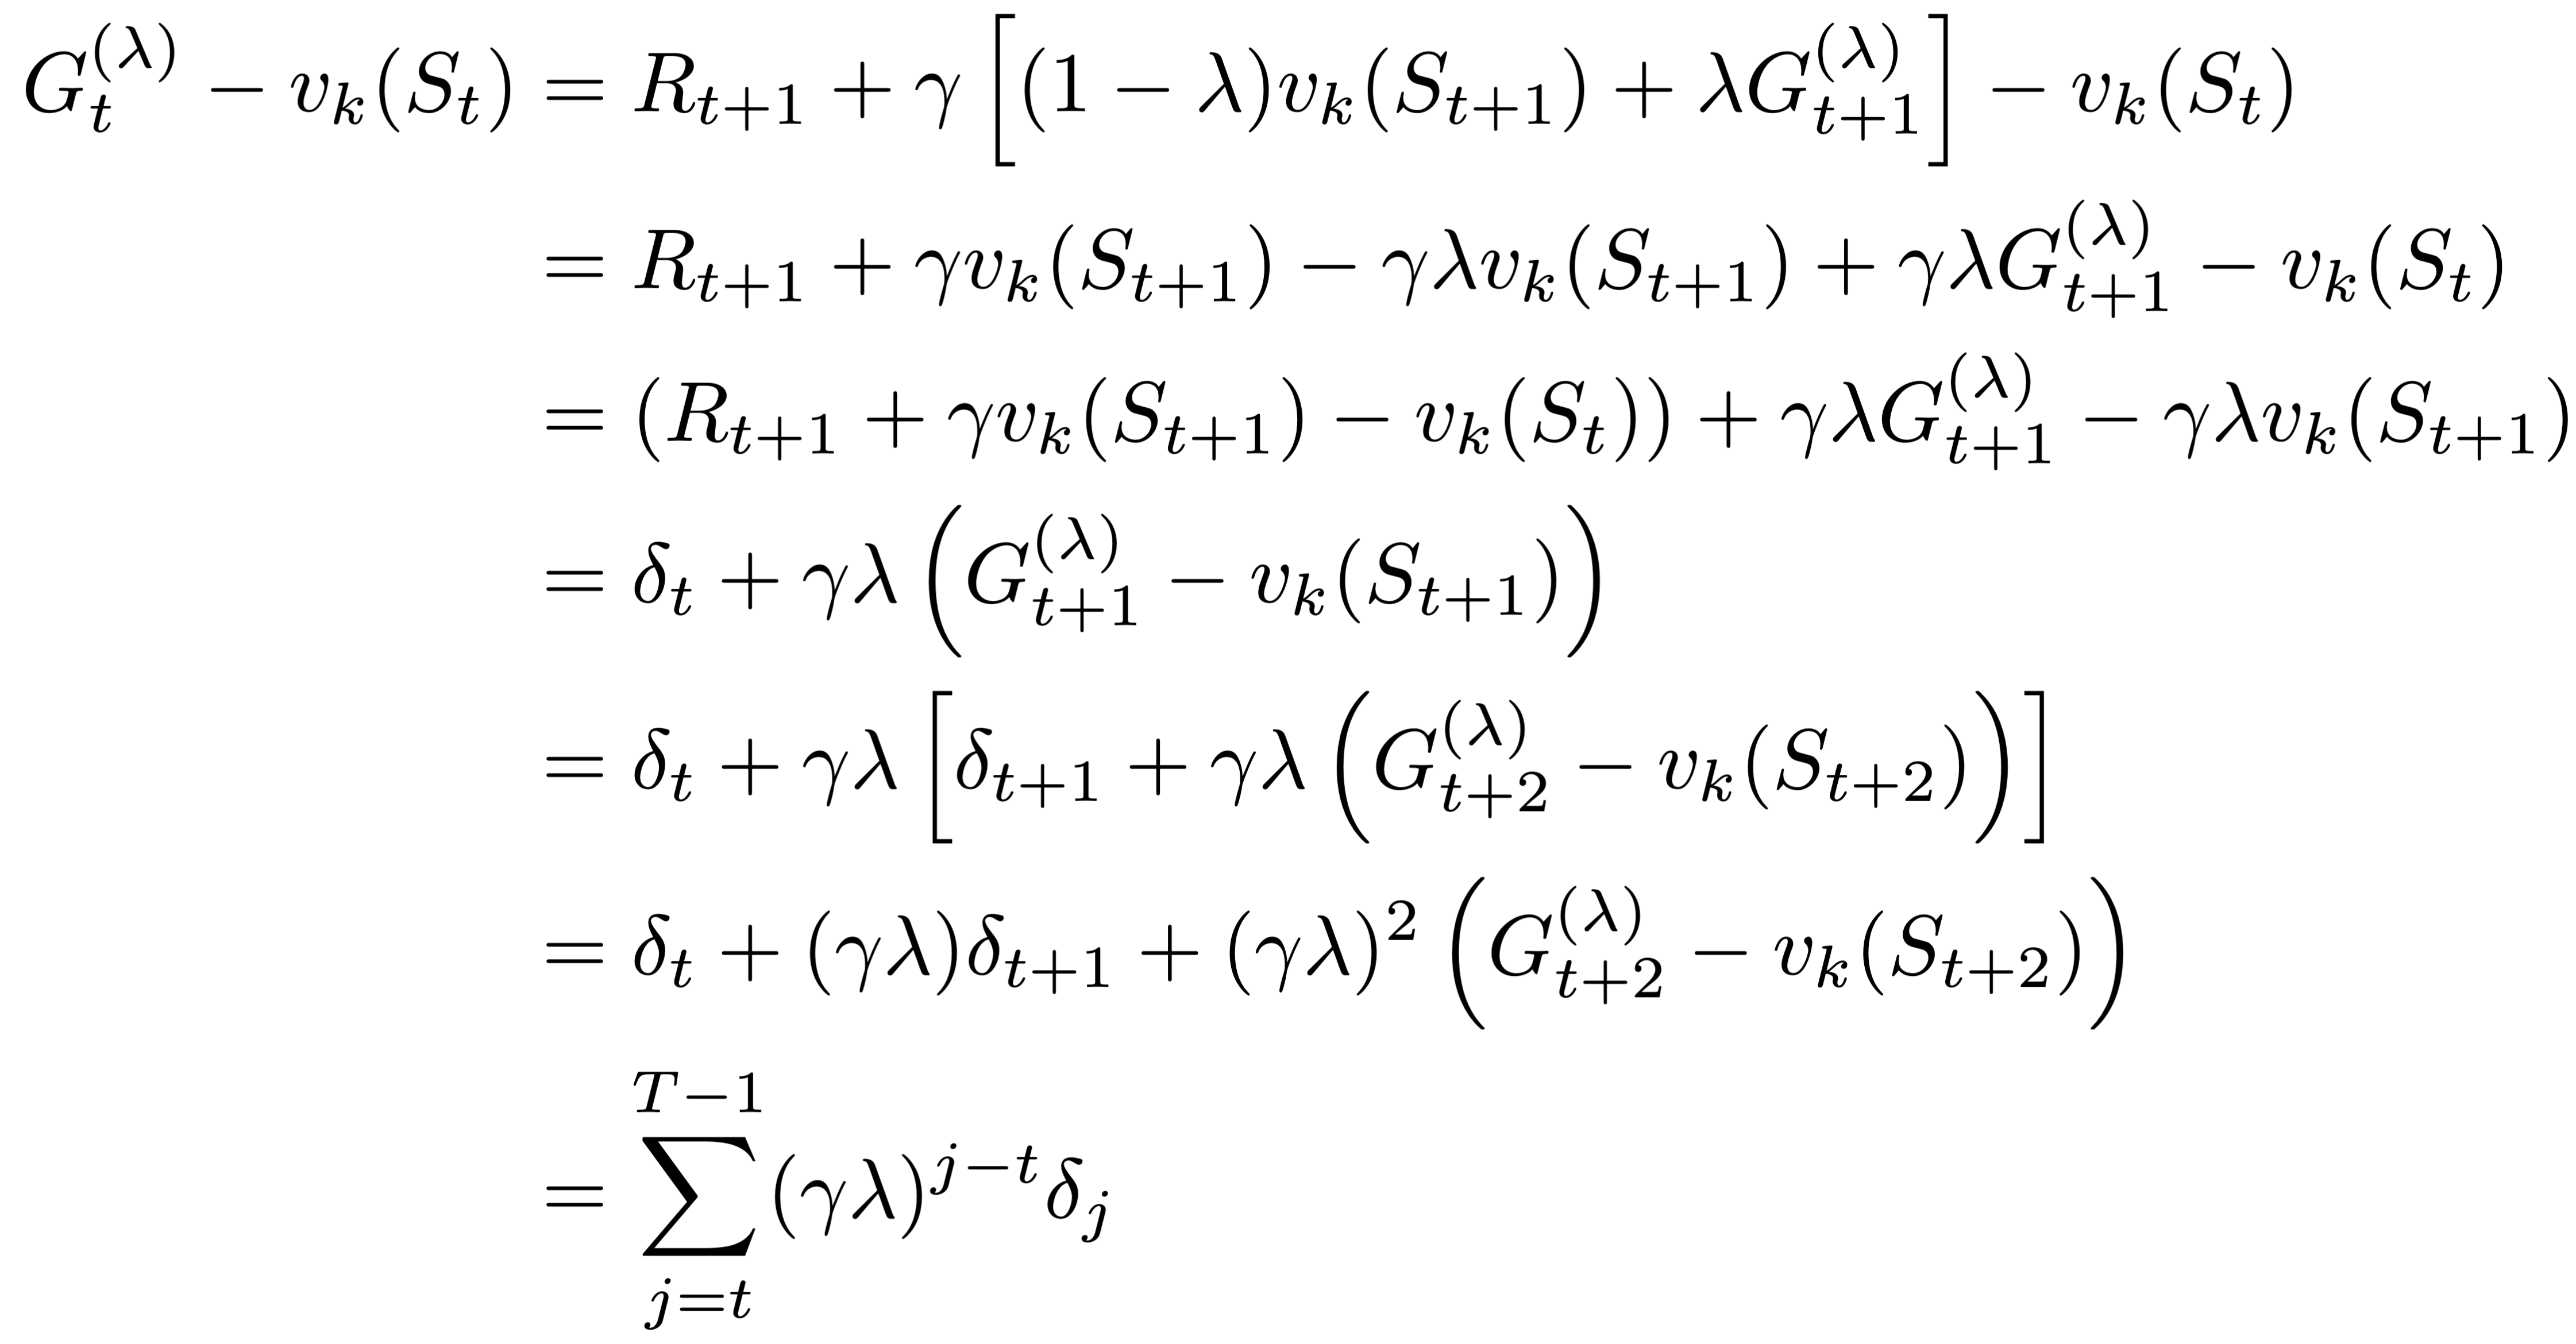
Expand the inner term
Identify the one-step TD error
What do the shaded terms represent?
Total change of
over an episode.
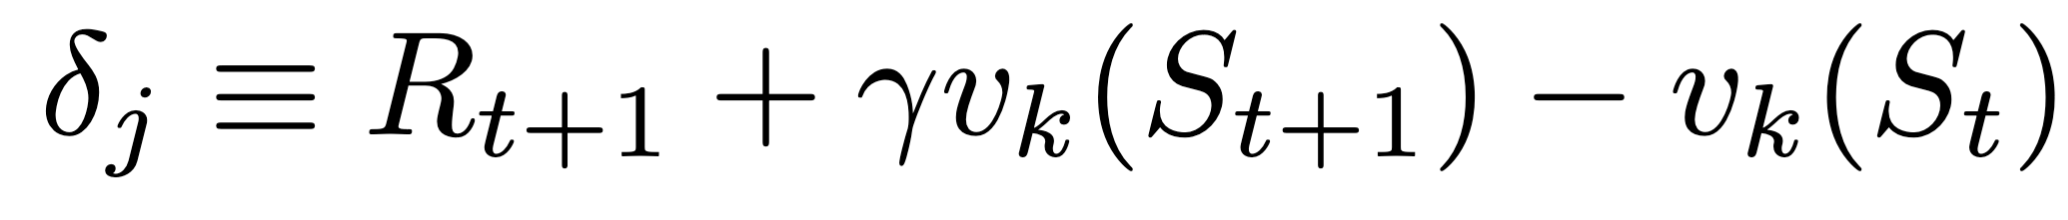
One-step TD error
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
Eligibility Traces
Mixed Multi-Step Returns
update equation


Try to derive
it at home.

Expand the inner term
Identify the one-step TD error
Substitute the one-step TD error
Recursive relation for the error term
Total change of
over an episode.

One-step TD error
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
Eligibility Traces
Mixed Multi-Step Returns
update equation


Try to derive
it at home.

Expand the inner term
Identify the one-step TD error
Substitute the one-step TD error
Recursive relation for the error term
Expand up to the terminal step T-1.
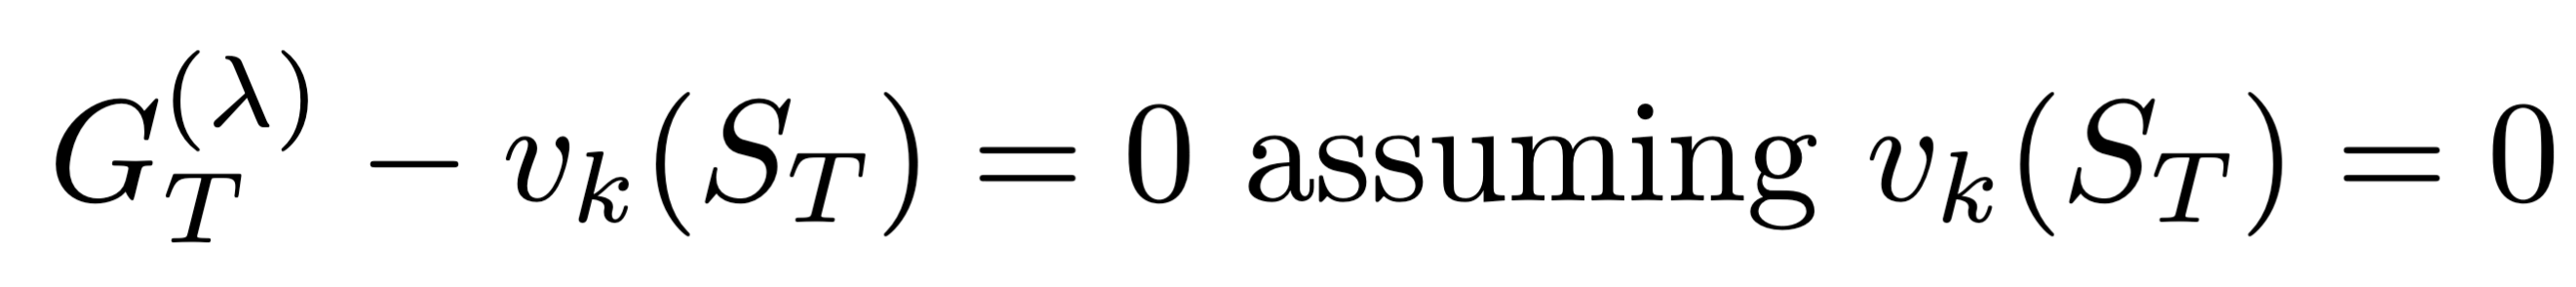
Total change of
over an episode.

One-step TD error
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
Eligibility Traces
Mixed Multi-Step Returns
update equation


Try to derive
it at home.

![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)
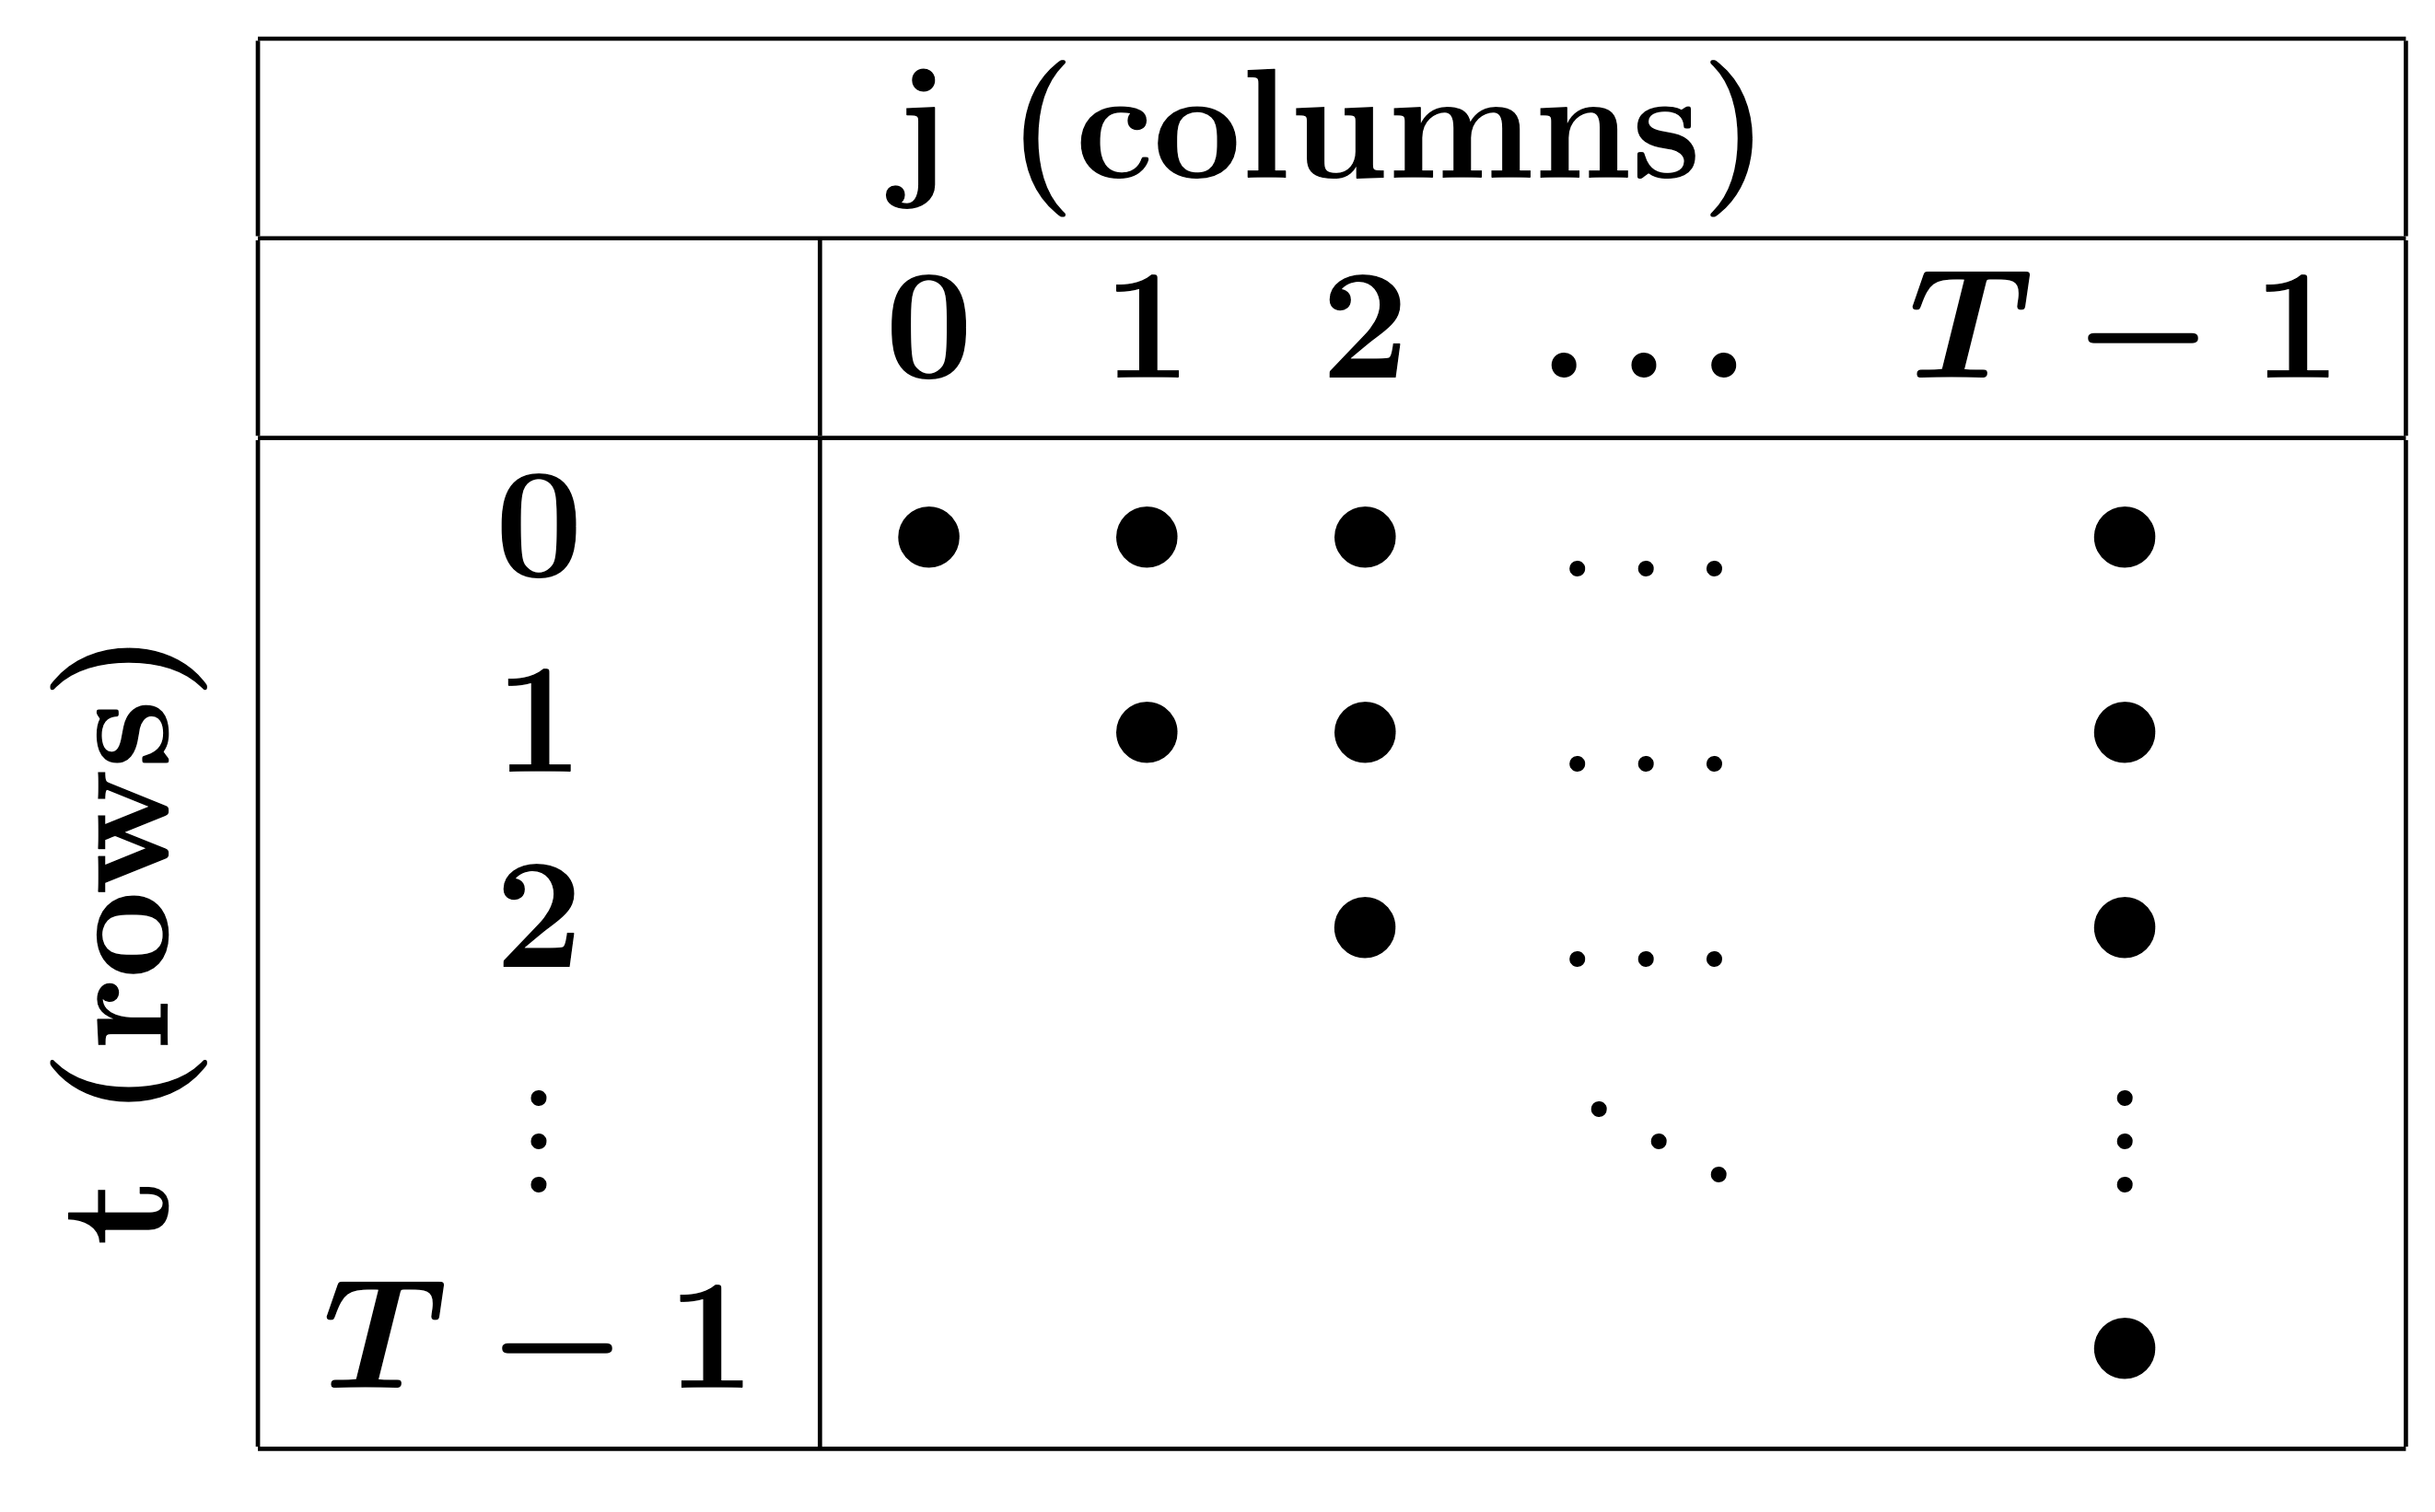
Change the order of summation

One-step TD error

Eligibility Traces
Mixed Multi-Step Returns
update equation


Try to derive
it at home.
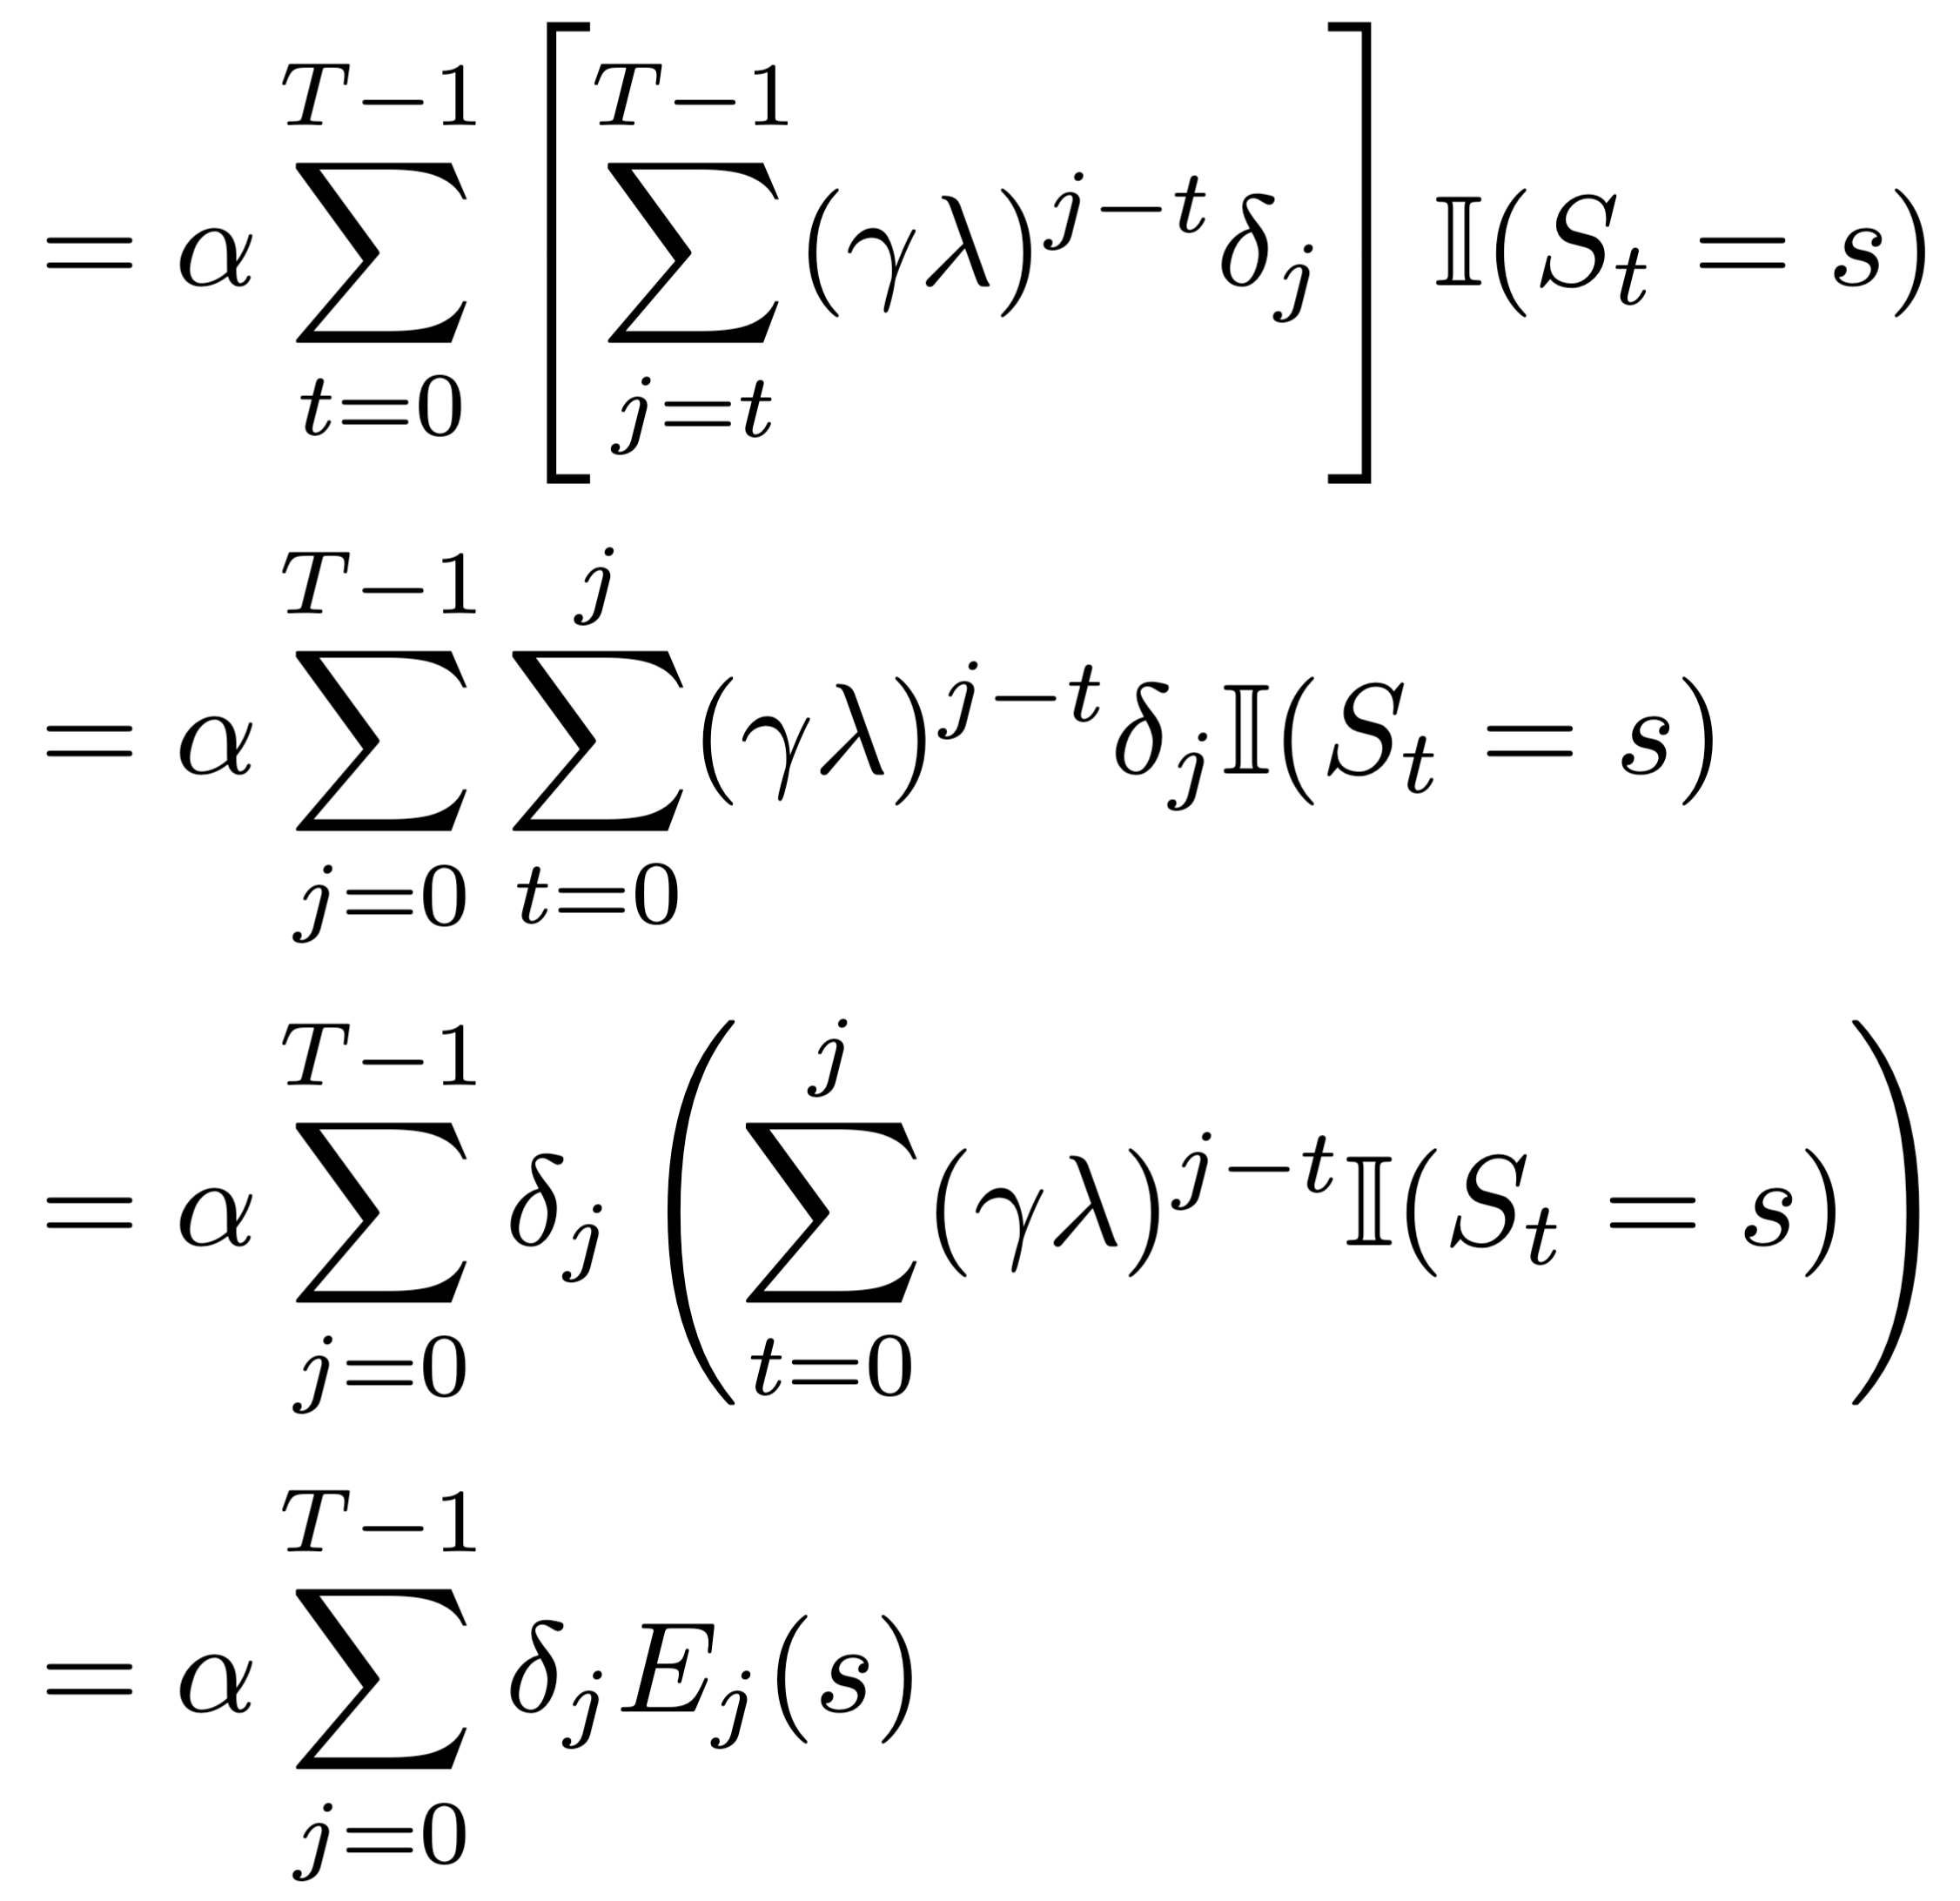
![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)
![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)
![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)
Change the order of summation

![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)

One-step TD error
Eligibility Traces
Mixed Multi-Step Returns
update equation


Try to derive
it at home.

![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)
![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)
![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)
![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)
Change the order of summation
Defined as Eligibility Traces:
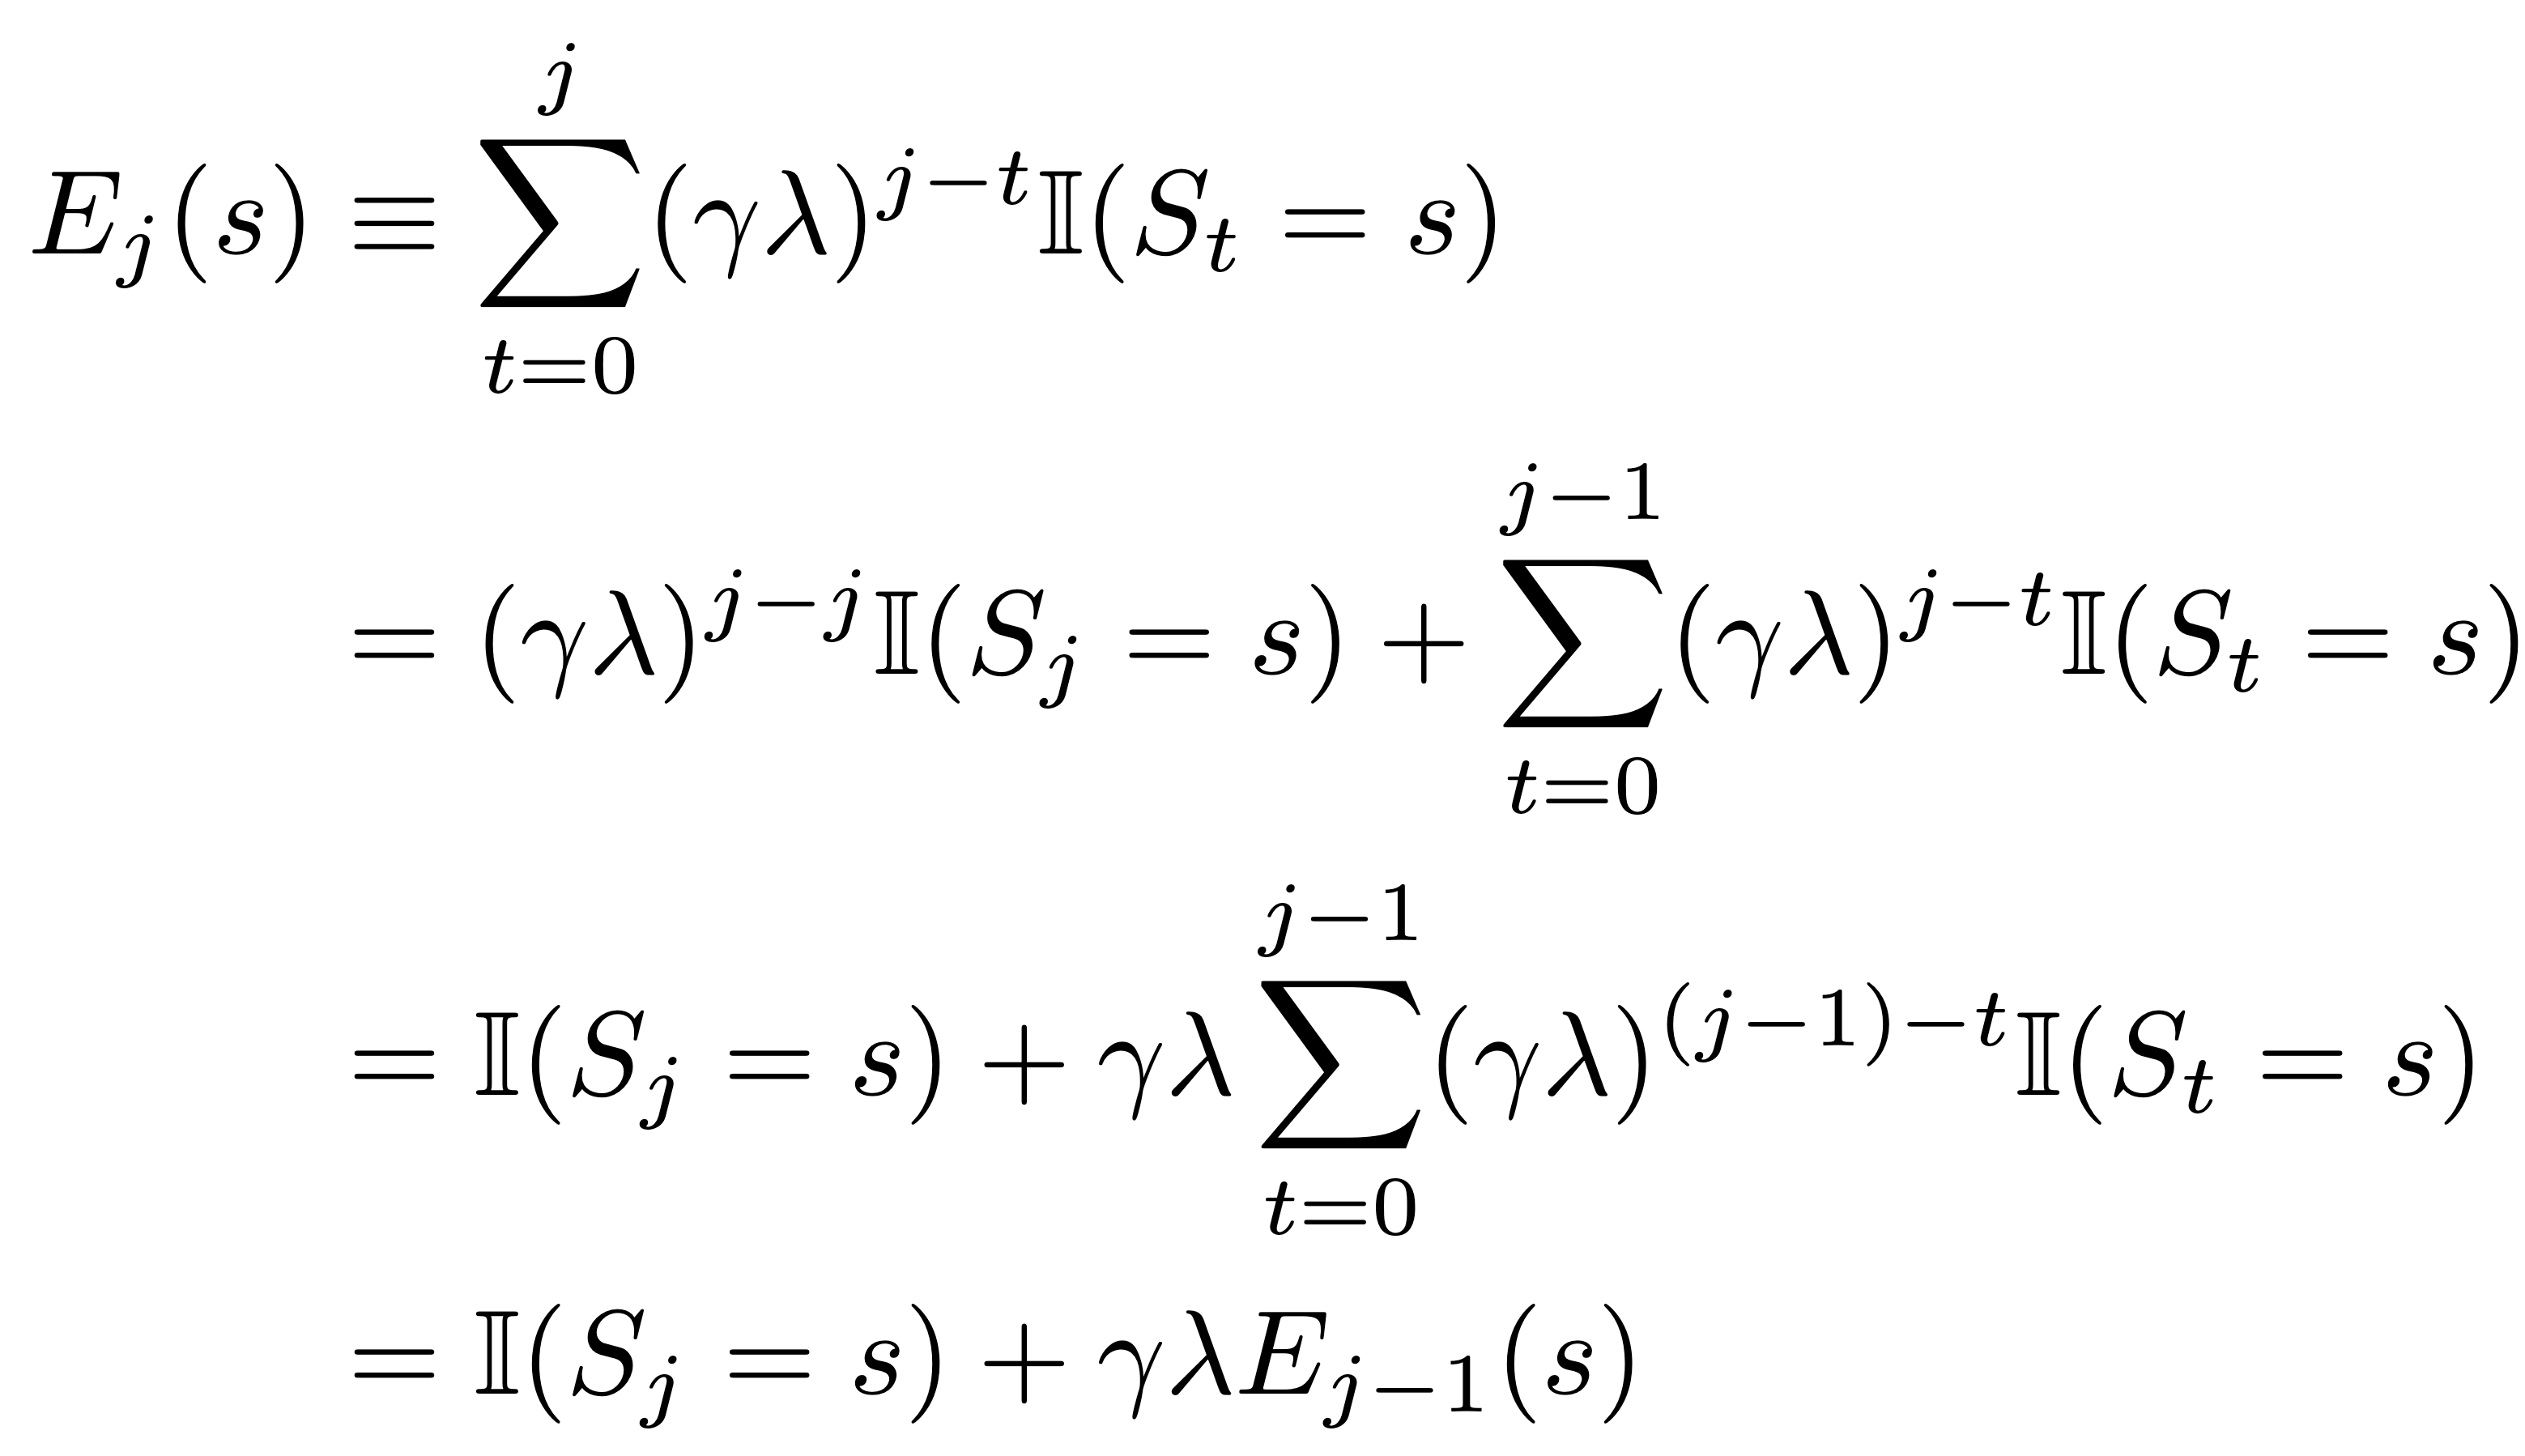
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)

One-step TD error
Eligibility Traces
Mixed Multi-Step Returns
update equation


Try to derive
it at home.

![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)

![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)

One-step TD error
Eligibility Traces
Recurse property of Eligibility Traces


Eligibility Traces
Mixed Multi-Step Returns
update equation


Try to derive
it at home.

![\begin{align*}
&= \alpha \sum_{t=0}^{T-1} \Bigg[ \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j \Bigg]\, \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \delta_j \mathbb{I}(S_t = s) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j \Bigg( \sum_{t=0}^{j} (\gamma\lambda)^{j-t} \mathbb{I}(S_t = s) \Bigg) \\ &= \alpha \sum_{j=0}^{T-1} \delta_j E_j(s)
\end{align*}](media/57b1cc4928.png)

![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)
![\begin{align*}
G_t^{(\lambda)} - v_k(S_t) &= R_{t+1} + \gamma \Big[ (1-\lambda) v_k(S_{t+1}) + \lambda G_{t+1}^{(\lambda)} \Big] - v_k(S_t) \\ &= R_{t+1} + \gamma v_k(S_{t+1}) - \gamma\lambda v_k(S_{t+1}) + \gamma\lambda G_{t+1}^{(\lambda)} - v_k(S_t) \\ &= (R_{t+1} + \gamma v_k(S_{t+1}) - v_k(S_t)) + \gamma\lambda G_{t+1}^{(\lambda)} - \gamma\lambda v_k(S_{t+1}) \\ &= \delta_t + \gamma\lambda \Big( G_{t+1}^{(\lambda)} - v_k(S_{t+1}) \Big) \\ &= \delta_t + \gamma\lambda \Big[ \delta_{t+1} + \gamma\lambda \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \Big] \\ &= \delta_t + (\gamma\lambda)\delta_{t+1} + (\gamma\lambda)^2 \Big( G_{t+2}^{(\lambda)} - v_k(S_{t+2}) \Big) \\ &= \sum_{j=t}^{T-1} (\gamma\lambda)^{j-t} \delta_j
\end{align*}](media/db7af86c60.png)

One-step TD error
Eligibility Traces
Recurse property of Eligibility Traces

![\renewcommand{\thealgorithm}{}
\begin{algorithm}
\caption{Tabular TD(\(\lambda\)) for estimating \(V \approx v_\pi\).}
\begin{algorithmic}[1]
\State Input: the policy $\pi$ to be evaluated
\State Algorithm parameters: step size \(\alpha \in (0, 1]\), \textcolor{red}{trace decay parameter \(\lambda \in [0,1]\)}
\State Initialize \(V(s)\), for all \(s \in \mathcal{S}^+\), arbitrarily except that \(V(\text{terminal}) = 0\) \\
\For{each episode}
\State Initialize \(S\)
\State \textcolor{red}{Initialize eligibility traces \(e(s) = 0\) for all states \(s \in \mathcal{S}\)}
\For{\(t=1, ..., T\) (until terminal state)}
\State $A \leftarrow$ action given by $\pi$ for $S$
\State Take action \(A\), observe \(R\), \(S'\)
\State \(\delta = R + \gamma V(S') - V(S)\)
\State \textcolor{red}{\(e(S) \leftarrow e(S) + 1\) }
\For{all states \(s \in \mathcal{S}\)}
\State \(V(s) \leftarrow V(s) + \alpha \delta \textcolor{red}{e(s)}\)
\State \textcolor{red}{\(e(s) \leftarrow \gamma \lambda e(s)\)}
\EndFor
\State \(S \leftarrow S'\)
\EndFor
\EndFor
\label{tabular TD(lambda)}
\end{algorithmic}
\end{algorithm}](media/95a2d80573.png)

Recurse property of Eligibility Traces

(Online algorithm!)
![\renewcommand{\thealgorithm}{}
\begin{algorithm}
\caption{Tabular TD(\(\lambda\)) for estimating \(V \approx v_\pi\).}
\begin{algorithmic}[1]
\State Input: the policy $\pi$ to be evaluated
\State Algorithm parameters: step size \(\alpha \in (0, 1]\), \textcolor{red}{trace decay parameter \(\lambda \in [0,1]\)}
\State Initialize \(V(s)\), for all \(s \in \mathcal{S}^+\), arbitrarily except that \(V(\text{terminal}) = 0\) \\
\For{each episode}
\State Initialize \(S\)
\State \textcolor{red}{Initialize eligibility traces \(e(s) = 0\) for all states \(s \in \mathcal{S}\)}
\For{\(t=1, ..., T\) (until terminal state)}
\State $A \leftarrow$ action given by $\pi$ for $S$
\State Take action \(A\), observe \(R\), \(S'\)
\State \(\delta = R + \gamma V(S') - V(S)\)
\State \textcolor{red}{\(e(S) \leftarrow e(S) + 1\) }
\For{all states \(s \in \mathcal{S}\)}
\State \(V(s) \leftarrow V(s) + \alpha \delta \textcolor{red}{e(s)}\)
\State \textcolor{red}{\(e(s) \leftarrow \gamma \lambda e(s)\)}
\EndFor
\State \(S \leftarrow S'\)
\EndFor
\EndFor
\label{tabular TD(lambda)}
\end{algorithmic}
\end{algorithm}](media/95a2d80573.png)
![\renewcommand{\thealgorithm}{}
\begin{algorithm}
\caption{Tabular TD($0$) for estimating \(V \approx v_\pi\).}
\begin{algorithmic}[1]
\State Input: the policy $\pi$ to be evaluated
\State Algorithm parameters: step size \(\alpha \in (0, 1]\)
\State Initialize \(V(s)\), for all \(s \in \mathcal{S}^+\), arbitrarily except that \(V(\text{terminal}) = 0\) \\
\For{each episode}
\State Initialize \(S\)
\For{\(t=1, ..., T\) (until terminal state)}
\State $A \leftarrow$ action given by $\pi$ for $S$
\State Take action \(A\), observe \(R\), \(S'\)
\State \(\delta = R + \gamma V(S') - V(S)\)
\State \(V(s) \leftarrow V(s) + \alpha \delta \)
\State \(S \leftarrow S'\)
\EndFor
\EndFor
\label{tabular TD(lambda)}
\end{algorithmic}
\end{algorithm}](media/0dda5ddf38.png)
(Online algorithm!)
Benefits of mixed multi-step returns
➢Mixed multi-step returns have benefits from both TD and MC
➢Bootstrapping can have issues with bias
➢Monte Carlo can have issues with variance
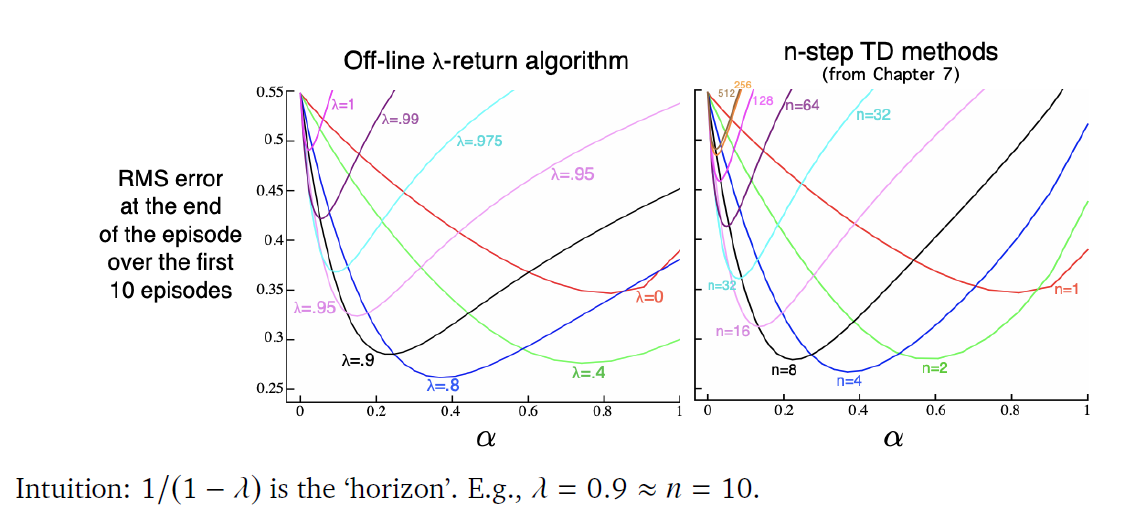
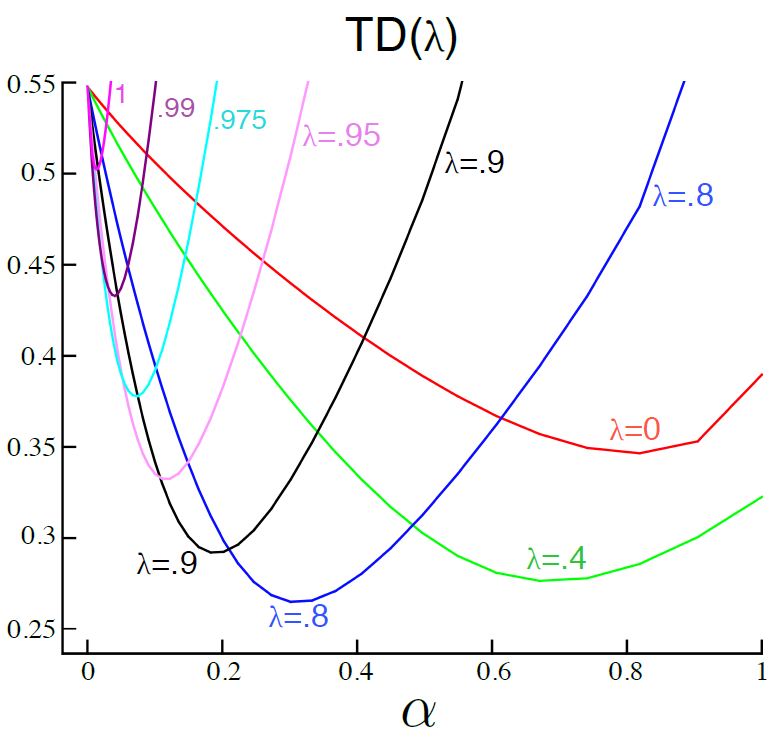
➢Typically, intermediate values of or are good (e.g., )
Mixed Multi-Step Returns


RMS error at the
end of the
episode over the
first 10 episodes
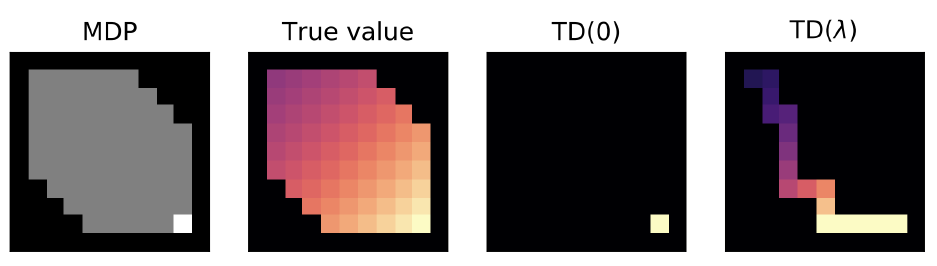
Gridworld visualization for TD(0) vs TD()
Take home message
•It is possible to evaluate a policy by only using sampled trajectories
•Monte Carlo algorithms sample returns.
•Unbiased estimates
•Higher Variance
•Time-Difference methods bootstrap
•Biased estimates
•Lower Variance
•Intermediate solutions try to get the best of both worlds
•-step TD
•TD()
Take home message
•Further studying:
•Sections 5.1, 5.2, 6.1, 6.2, 6.3, 7.1, 7.2, 12.1, 12.2– Reinforcement Learning: An introduction
•Short notes:
•Monte Carlo: https://people.stfx.ca/jdelamer/courses/csci-531/lectures/rl/monte-carlo/monte-carlo-
methods.html
•TD-learning: https://people.stfx.ca/jdelamer/courses/csci-531/lectures/rl/Temporal-
difference%20learning/td-learning.html
•Video (UCL x DeepMind)
•Lectures 5:
https://www.youtube.com/watch?v=eaWfWoVUTEw&list=PLqYmG7hTraZCRwoyGxvQkqVrZgDQi4m-
5&index=5&t=13s
•Next lecture:
•MC control, SARSA, Q-learning, Double Q-learning, DQN